
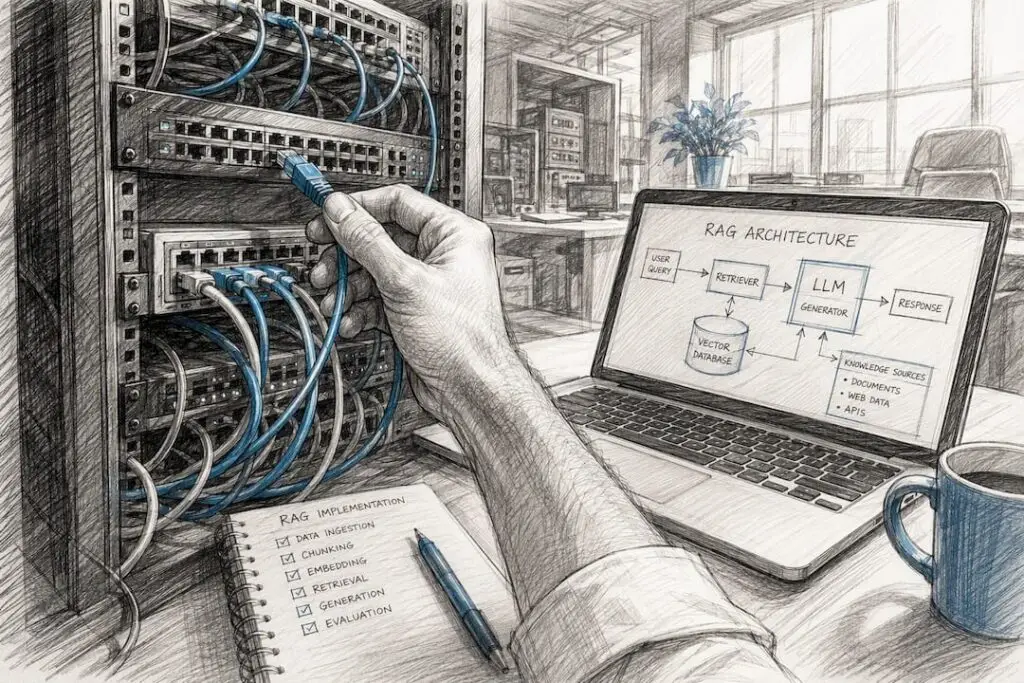
A többnyelvű RAG olyan lekérdezés alapú generálási architektúra, amely eltérő nyelvű dokumentumforrásokból dolgozik, és a felhasználó saját nyelvén ad forrásmegjelölt, ellenőrizhető választ. Az üzleti érték egyszerű: a vállalat nem kényszerül egyetlen nyelvre szűkíteni a tudásbázisát, mégis auditálható marad minden válasz eredete. A rendszer gerincét a dokumentumból való lekéréses generálás adja: chunkolás, embedding, vektoros keresés, reranker és generátor egymásra épülő láncolata.
Röviden:
- A többnyelvű RAG rendszerben a releváns dokumentumokat nyelvfüggő chunkolás, nyelvspecifikus vagy nyelvfüggetlen embeddingek és központi vektoradatbázis biztosítja.
- A nyelvi torzítás miatt a rendszer gyakran az angol vagy a felhasználó által preferált nyelvet részesíti előnyben, még akkor is, ha más nyelven találhatók relevánsabb források.
- A jó eredmények érdekében a rendszernek célnyelvre fordított promptsablont és auditálási folyamatokat kell alkalmazni, valamint kockázatmentesen inductív módon tanítani.
- A sikeres többnyelvű RAG bevezetés alapja a magas adatminőség és az erős governance, nemcsak a kiváló modellválasztás.
- Pilot projekt indítása csak akkor indokolt, ha legalább két nyelven elérhető, strukturált dokumentumgyűjtemény és mérhető KPI-k vannak.
Tartalomjegyzék
- RAG csővezeték: chunkolás, embeddingek, vektoradatbázis, retriever, reranker, generator
- Miért torzít a rendszer az egyik nyelv felé?
- Tervezési minták a nyelvi torzítás csökkentésére
- Hogyan építsük fel a többnyelvű RAG-ot lépésről lépésre?
- Mit mérjünk, hogy lássuk, működik a rendszer?
- Governance, adatbiztonság és auditálhatóság vállalati bevezetéskor
- Mit tanultunk a Stratify AI éles RAG-projektjeiből?
- Mikor éri meg elindítani a pilotot?
- A Stratify meglátása: hol dől el valójában a siker?
- Hogyan indítsa el a Stratify a többnyelvű RAG bevezetését?
- Források
RAG csővezeték: chunkolás, embeddingek, vektoradatbázis, retriever, reranker, generator
A RAG nem egyetlen modell, hanem egy összeszerelt gépezet, amelynek minden állomása külön hibaforrás lehet. Az első lépés a chunkolás: a dokumentumot kezelhető méretű darabokra vágjuk, mert egy teljes szerződés vagy kézikönyv beemelése a promptba drágán és pontatlanul működne. A chunk mérete kompromisszum: túl kicsi darab elveszíti a kontextust, túl nagy darab felhígítja a releváns információt a lekérdezéskor.
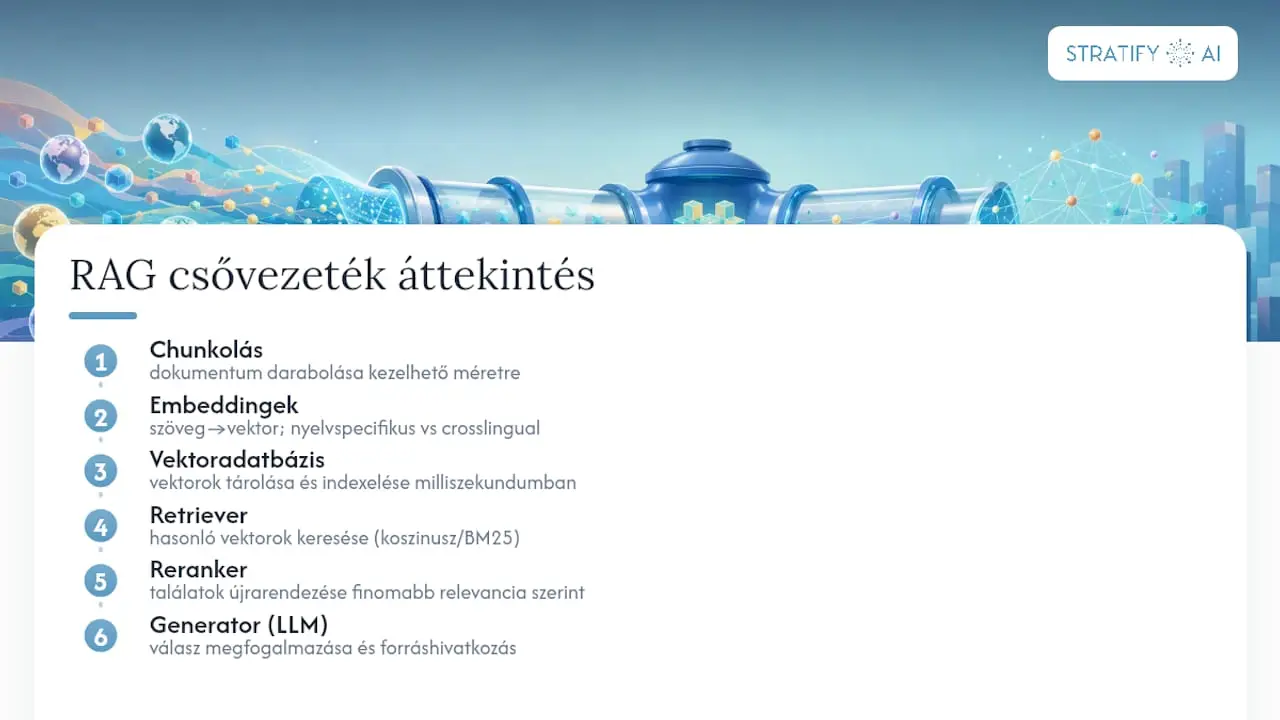
Ezután jön az embedding, vagyis a szöveg számmá alakítása egy vektortérben. Itt válik döntővé a nyelvi kérdés: egy nyelvspecifikus embeddingmodell jobban érti a magyar nyelvtani árnyalatokat, míg egy nyelvfüggetlen (crosslingual) modell azt teszi lehetővé, hogy egy magyar kérdés angol vagy német dokumentumra is rátaláljon. Sok vállalati implementáció a kettő kombinációját választja: nyelvfüggetlen modellt a keresésre, nyelvspecifikus finomhangolást a releváns iparági terminológiára.
A vektoradatbázis tárolja és indexeli ezeket a vektorokat, hogy a keresés milliszekundumok alatt lefusson akár több millió dokumentumrészlet között is. Az indexelés minősége közvetlenül befolyásolja a válaszidőt és a találati pontosságot.
A retriever a felhasználó kérdéséhez hasonló vektorokat keres meg, jellemzően koszinusz hasonlóság vagy klasszikus szövegkeresési módszerek, mint az Okapi BM25, kombinációjával. A reranker ezután újrarendezi a találatokat egy finomabb relevanciamodell szerint, mert a nyers vektorkeresés gyakran zajos. Végül a generator, vagyis maga az LLM, ezekből az anyagokból fogalmazza meg a választ, és jó esetben pontosan hivatkozza is a forrást.
Miért torzít a rendszer az egyik nyelv felé?
A nyelvi torzítás azt jelenti, hogy a reranker és a generátor rendszeresen felülértékeli az angol vagy a lekérdezés nyelvén írt dokumentumokat, még akkor is, ha egy másik nyelvű forrás relevánsabb választ adna. Ez nem elméleti probléma. A jelenség mérhető, és éles környezetben ügyféladat-vesztéshez vagy félrevezető válaszhoz vezet.
A reranker → generátor lánc jelentős teljesítménykiesést is okozhat az elméleti optimumhoz képest, amikor a modell nem a megfelelő nyelvű forrást részesíti előnyben egy nemrégiben publikált kutatás szerint. Ez azt jelenti, hogy egy magyar nyelvű vállalati tudásbázisban, ahol a dokumentumok fele angolul íródott, a rendszer könnyen “elfelejtheti” a magyar forrásokat, még ha azok pontosabbak is.
A helyes nyelven válaszolás mérésére szolgál a CRL (correct language rate), vagyis az arány, hogy a generátor tényleg a felhasználó nyelvén válaszol-e. Alacsony CRL érték gyakran nem fordítási hiba, hanem az, hogy a generátor egyszerűen az angol forrást preferálja a válasz megfogalmazásakor.
Code-switching is nehezíti a helyzetet: amikor egy magyar dokumentum angol szakkifejezéseket vagy terméknevet tartalmaz, a rendszer könnyen összekeveri az entitásokat, vagy angolosítja azokat ott is, ahol ez félrevezető. Egy vegyes nyelvű ügyféllevelezésben a “delivery note” és a “szállítólevél” ugyanazt jelentheti, de a retriever külön entitásként kezelheti, ha nincs entitásfeloldás. Az alacsony erőforrású nyelvek (kevés tréningadat, ritka nyelvtani szerkezet) a legkitettebbek: ezekre a nyelvekre gyengébb az embeddingmodell lefedettsége, így a keresés eleve pontatlanabb kiindulóponttal indul.
Tervezési minták a nyelvi torzítás csökkentésére
A LAURA és hasonló utility-driven reranker megközelítések nem a klasszikus relevancia-szignálokra tanítják a rerankert, hanem arra, hogy a kiválasztott dokumentum ténylegesen mennyire segíti a generátort jó válasz megfogalmazásában. Ez a különbség lényeges: egy dokumentum lehet témában releváns, mégis rosszul hasznosítható, ha a generátor nem tudja megfelelően beépíteni a válaszba. Az utility alapú tanítás mérhetően csökkenti a nyelvi preferenciát, mert a rerankert nem a nyelv, hanem a végeredmény minősége alapján jutalmazza.
Két fő stratégia verseng egymással a gyakorlatban. A CrossRAG a lekért dokumentumokat egy közös nyelvre, jellemzően a felhasználó nyelvére, fordítja a generálás előtt. Kutatási eredmények szerint ez stabilabb eredményt ad alacsony erőforrású nyelveknél, mint a natív többnyelvű retriever, mert a generátor így egynyelvű kontextusból dolgozik. A hátránya, hogy a fordítási réteg plusz latenciát és költséget jelent, és a fordítási hibák tovább öröklődnek a válaszba. A natív többnyelvű retriever ezzel szemben egy közös vektortérben kezeli az összes nyelvet fordítás nélkül, ami gyorsabb, de érzékenyebb a fentebb tárgyalt nyelvi torzításra.
A knowledge graph integráció harmadik réteget ad a rendszerhez: az entitások és kapcsolataik explicit strukturálásával a válasz eredete pontosabban visszakövethető, ami különösen fontos szabályozott iparágakban, ahol egy állítást tételesen alá kell tudni támasztani egy konkrét dokumentumrészlettel.
A chunkolási stratégia is nyelvfüggő döntés. A rekurzív vagy ágensalapú darabolás jobban megőrzi a kontextust, mint a fix méretű vágás, mert a nyelvek eltérő mondathossza és szórendje miatt egy azonos karakterszámú chunk teljesen más mennyiségű jelentést hordozhat magyarul, mint például kínaiul.
Hogyan építsük fel a többnyelvű RAG-ot lépésről lépésre?
A pilot projekttől az éles rendszerig vezető út tervezhető, ha a lépéseket sorrendben, ellenőrzési pontokkal kezeljük.
- Adatfelmérés és forráskatalógus. Térképezzük fel, mely nyelveken, milyen formátumban és milyen frissítési gyakorisággal léteznek a releváns dokumentumok.
- OCR és nyelvi előfeldolgozás. Szkennelt szerződéseknél és PDF-eknél a gyenge minőségű OCR önmagában tönkreteheti a legjobb modellt is, ezért nyelvenként külön kell validálni a szövegkinyerést.
- Chunkolás nyelvspecifikusan. Válasszunk eltérő chunkméretet a hosszú összetett mondatokra hajlamos nyelvekhez képest a tömörebb szerkezetű nyelvekhez.
- Embedding pipeline kialakítása. Döntsük el, hogy nyelvfüggetlen vagy nyelvspecifikus modellt, esetleg kettő kombinációját használjuk, és tervezzük meg az újraindexelés gyakoriságát.
- Indexelés és retriever+reranker konfiguráció. Állítsuk be a vektoradatbázist és teszteljük a reranker viselkedését minden célnyelven külön.
- Prompt engineering a felhasználói nyelvre. Explicit, célnyelvre fordított rendszerprompt jelentősen javítja a válasz nyelvi helyességét, ahogy ezt többnyelvű RAG-kutatások is megerősítik.
- Frissítési és audit pipeline. Rögzítsük, mikor és milyen forrásból frissült az index, hogy minden válasz visszakövethető legyen.
Profi tipp: Ne bízzuk a fordítást kizárólag gépi motorra a rendszerprompt szintjén. Egy szakértő által lektorált célnyelvi promptsablon gyakran nagyobb javulást hoz a válaszminőségben, mint egy drágább generátormodellre váltás.
Mit mérjünk, hogy lássuk, működik a rendszer?
A retrieval recall és precision megmutatja, hogy a retriever egyáltalán megtalálja-e a releváns dokumentumokat, függetlenül attól, hogy a generátor mit kezd velük. A CRL, vagyis a helyes nyelven adott válaszok aránya, külön mérőszám, mert egy rendszer találhat releváns angol dokumentumot, mégis rosszul teljesít, ha a válasz nem magyarul érkezik. A generation recall és precision azt vizsgálja, hogy a végső válasz ténylegesen tartalmazza-e a forrásban szereplő tényeket, torzítás vagy kihagyás nélkül.
Az utility-driven értékelés, amit a LAURA-típusú megközelítéseknél már említettünk, egy orákulum-elemzéssel veti össze, hogy egy “tökéletes” dokumentumválasztás mennyivel jobb választ adna, mint amit a rendszer ténylegesen produkált. Ez a különbség megmutatja, hol veszít a rendszer a lehetséges optimumhoz képest.
Az automatikus metrikák nem helyettesítik a manuális felülvizsgálatot. Célszerű minden nyelvi szegmensből reprezentatív mintát kézzel ellenőrizni, különös figyelemmel az alacsony erőforrású nyelvekre, ahol az automatikus mérőszámok is torzíthatnak. Ezeket a mérési rutinokat érdemes beépíteni a frissítési pipeline-ba, hogy minden új dokumentumkötegnél újrafusson az ellenőrzés.
Governance, adatbiztonság és auditálhatóság vállalati bevezetéskor
Egy többnyelvű RAG bevezetésekor az adat-szuverenitás és jogosultságkezelés nem utólagos ráadás, hanem tervezési alapkérdés: ki férhet hozzá melyik nyelvű, melyik érzékenységi szintű dokumentumhoz. A forrásmegjelölés és auditálhatóság gyakorlati eleme, hogy minden generált válasz mellé konkrét dokumentumhivatkozás kerüljön, ne csak általános “a tudásbázis alapján” jellegű megjegyzés.
A kockázatcsökkentés legjobb eszköze egy jól körülhatárolt pilot, amely egy szűk dokumentumkörön és egy vagy két nyelven méri a ROI-t, mielőtt a teljes vállalati tudásbázisra terjesztenék ki. A humán-ellenőrzés és az incident management folyamat biztosítja, hogy egy hibás vagy félrevezető válasz ne maradjon észrevétlen, hanem visszacsatolási hurokban javítható legyen.
Mit tanultunk a Stratify AI éles RAG-projektjeiből?
A Stratify AI tanácsadói és fejlesztői munkája során a tudásmenedzsment rendszerek bevezetése rendre ugyanarra a mintára fut ki: a technikai modellválasztás ritkán a szűk keresztmetszet, sokkal inkább az adatelőkészítés és a forrásmegjelölés fegyelmezettsége. A SharePoint-alapú tudásbázisokra épülő RAG-bevezetéseknél a hallucináció csökkentése jellemzően a chunkolási stratégia és a rendszerprompt finomhangolásán múlik, nem a generátormodell cseréjén.
A RAG alapú rendszerek versenyelőnyt teremtő hatását ott láttuk a legerősebben, ahol a vállalat előbb egy szűk, jól körülhatárolt pilotot futtatott: mérhető válaszidő, ellenőrizhető forráshivatkozás, és egy kézzel validált mintahalmaz alapján mért pontosság. A gyors nyereség szinte mindig a rosszul strukturált, vegyes nyelvű dokumentumkészlet rendberakásából jön, még mielőtt bármilyen fejlettebb reranker bevezetésre kerülne.
Mikor éri meg elindítani a pilotot?
Pilot indítása akkor indokolt, ha a vállalatnak van legalább két nyelven strukturált, hozzáférhető dokumentumkészlete, és világos KPI-t tud kijelölni: CRL javulása, retrieval recall, válaszidő. A gyors nyereség jellemzően az adattisztításból és a chunkolás finomhangolásából jön, nem a legújabb modellváltásból. A következő lépés egy discovery workshop, ahol a pilot terjedelmét és a mérési pontokat közösen rögzítik.
A Stratify meglátása: hol dől el valójában a siker?
A saját tapasztalatunk szerint a többnyelvű RAG sikerének 80 százaléka az adatminőségen és a governance-en múlik, nem a modellváláson. A pilot nem díszlépés, hanem az egyetlen módja annak, hogy a humán-ellenőrzést beépítve, kontrollált kockázattal tanuljunk a valós adatból. A technológia gyorsan fejlődik, de a pragmatikus üzleti fókusz, vagyis a mérhető KPI-k és az auditálható válaszok, nem évülnek el.
— Zsolt
Hogyan indítsa el a Stratify a többnyelvű RAG bevezetését?
A Stratify AI nem egy technológiai csomagot ad el, hanem egy olyan bevezetési utat, amely a pilot mérési pontjaitól a governance-kereteken át az éles üzemeltetésig terjed.

Ha a vállalatnál több nyelven, szétszórt formátumban léteznek a dokumentumok, egy AI-stratégiai workshop segít feltérképezni, hol van a leggyorsabban mérhető üzleti haszon: melyik osztályon, melyik dokumentumkörön és melyik nyelvpáron érdemes elindítani az első pilotot. A Stratify csapata a discovery szakaszban a forráskatalógustól a CRL-célkitűzésig minden döntési pontot végigvisz, mielőtt egyetlen sor kód is megszületne. Foglaljon egy AI tanácsadási konzultációt, és tisztázzuk közösen, hol áll a vállalata a többnyelvű tudásmenedzsment kiépítésében.
Források
A nyelvi torzítás mérésével foglalkozó kutatás részletes technikai hátteret ad az utility-driven reranker megközelítésekhez, míg a crosslingual RAG-stratégiákról szóló tanulmány a fordítás-alapú és natív többnyelvű módszerek összevetését mutatja be. A többnyelvű generálásról szóló ACL-publikáció a prompt engineering gyakorlati szerepét járja körül, a Corvinus kutatási archívum anyaga pedig az adatelőkészítés és OCR buktatóit tárgyalja implementátorok számára. Technikai lokalizációs kérdésekhez hasznos kiindulópont a szakmai dokumentumfordításról szóló összefoglaló is.
- Mi a lekéréses kibővített generálás (RAG)? — Azure
- All languages matter: Understanding and mitigating language bias in multilingual RAG — arXiv (2604.20199)