
A privát keresés olyan kontrollált belső keresőrendszer, amely kizárólag a felhasználó jogosultságainak megfelelő tartalmat tárja fel, soha nem küld ki vállalati adatot ellenőrizetlen külső szolgáltatásnak. Az első lépés nem a technológia kiválasztása, hanem a DPIA elvégzése és a governance felállítása. Ez az alap dönti el, hogy a projekt biztonságos marad-e, és hogy a bevezetés valódi üzleti értéket hoz-e.
Röviden:
- Személyes adatokat, például leveleket vagy HR iratokat indexelő rendszer előtt már a projekt elején végezzen adatvédelmi hatásvizsgálatot, ne utólagos jóváhagyásként.
- A helyben működtetett rendszer nagyobb kezdeti beruházást és üzemeltetési terhet igényel; felhőalapú megoldást csak megfelelő adatkezelési és szerződéses garanciák mellett válasszon.
- A lekérdezéssel kiegészített generálás csak akkor biztonságos, ha a visszakeresés a forrásrendszerek jogosultságait is érvényesíti; az elavult index jogosulatlan hozzáférést okozhat.
- Indítson szűk pilotot előre rögzített relevancia, pontosság, válaszidő és megfelelőségi mérőszámokkal, majd csak az üzleti és megfelelőségi feltételek teljesülésekor bővítsen.
- Harmadik fél bevonásakor tisztázza az adattárolás helyét, megőrzési idejét és a lekérdezések szolgáltató általi, modelljei tanítására való felhasználását; vizsgálja át a szerződést és az alvállalkozókat.
Tartalomjegyzék
- Mi a privát keresés és miért van rá szükség vállalati környezetben?
- Architekturális lehetőségek: on-prem, hibrid és RAG
- Biztonság és megfelelőség: ellenőrzőlista IT-nek és adatvédelemnek
- Megvalósítási lépések: pilot indítása, mérőszámok és skálázás
- Vendor due diligence és a harmadik fél modellek jogi ellenőrzése
- Költség és üzleti érték: mire számítson a ráfordítások oldalán
- Kiválasztási szempontok a privát keresési megoldások értékeléséhez
- Gyakorlati üzleti esetek a vállalati tudáskezelésben
- Képzés és szervezeti felkészítés a bevezetéshez
- Mikor érdemes külső tanácsadót bevonni?
- Hogyan segítünk a privát keresés bevezetésében
- Gyakran ismételt kérdések
- Források
Mi a privát keresés és miért van rá szükség vállalati környezetben?
A privát keresés technikailag azt jelenti, hogy a vállalati dokumentumokat, e-maileket, projektfájlokat és tudásbázisokat egy belső indexbe szervezzük, miközben minden egyes dokumentumhoz megőrizzük az eredeti hozzáférési jogosultságokat. Amikor valaki keres, a rendszer csak azokat a találatokat mutatja, amelyekhez az adott felhasználónak ténylegesen joga van hozzáférni. Ez alapvetően különbözik attól, amikor valaki egyszerűen bemásol egy belső dokumentumot egy nyilvános nagy nyelvi modellbe: ott a tartalom elhagyja a vállalat ellenőrzött környezetét, és nincs garancia arra, hogy ki fér hozzá utólag, vagy hogy a szolgáltató mire használja fel az adatot.
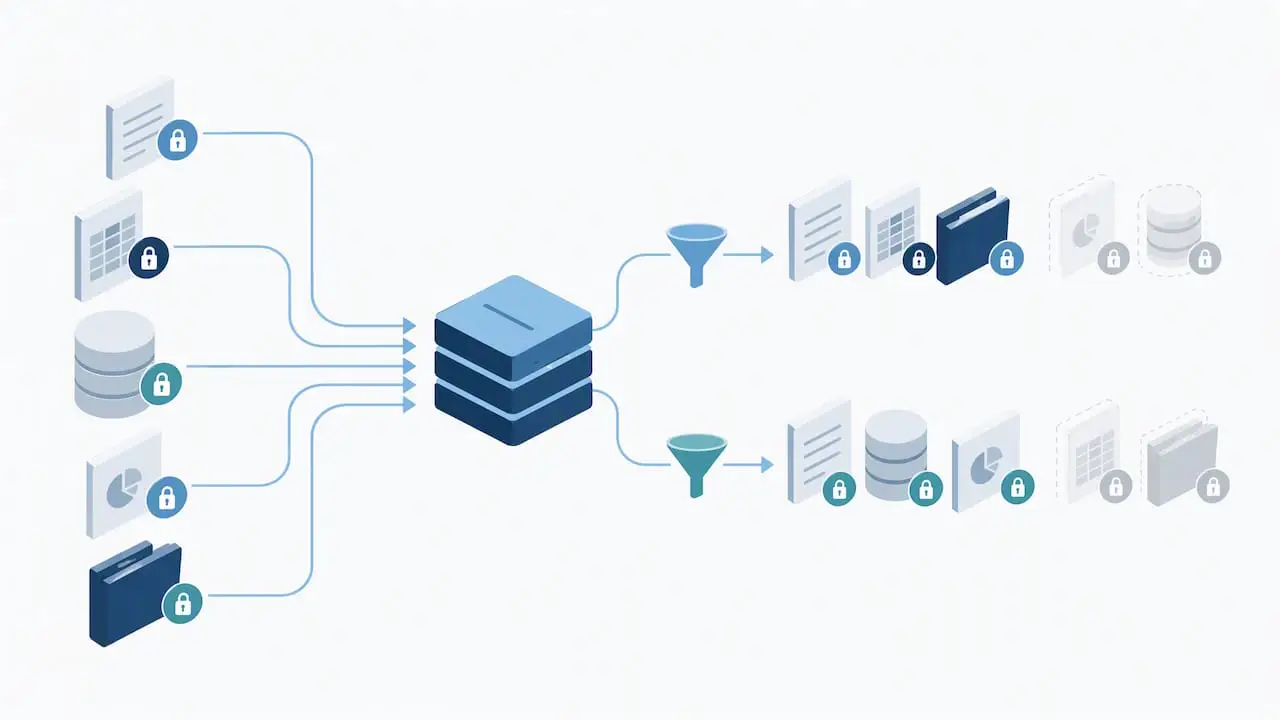
Egy nyilvános LLM-lekérdezés kényelmes, de nem helyettesíti a strukturált belső keresést. Hiányzik belőle a jogosultságkezelés, a verziókövetés és az auditálhatóság, vagyis pontosan azok az elemek, amelyek vállalati környezetben elengedhetetlenek. A vállalati adatokon tanított AI megoldások ezzel szemben úgy épülnek fel, hogy a szervezet saját tudásanyagát használják fel, miközben a hozzáférési szabályok érvényben maradnak.
A privát keresés bevezetésének üzleti haszna konkrét és mérhető:
- Gyorsabb döntéshozatal, mert a munkatársak percek alatt megtalálják a releváns szerződést, specifikációt vagy korábbi projektdokumentumot.
- Hatékonyabb ügyfélszolgálat, mivel a kollégák azonnal hozzáférnek a termékdokumentációhoz és a korábbi esetekhez.
- Jobb tudásmegosztás, mert a szétszórt fájlrendszerekben, levelezésben és megosztott meghajtókon elveszett ismeret újra kereshetővé válik.
Architekturális lehetőségek: on-prem, hibrid és RAG
Az IT csapatnak több architekturális utat érdemes mérlegelnie, és mindegyiknek megvannak a maga kompromisszumai.
- On-prem megoldás: minden adat és modell a vállalat saját infrastruktúráján fut, ami maximális kontrollt ad a megfelelőség és az adatbiztonság felett, cserébe magasabb üzemeltetési terhet és beruházási igényt jelent.
- Hibrid architektúra: az érzékeny adatok helyben maradnak, miközben az indexelés, a keresőmotor vagy a modell egy része felhőben fut, ez rugalmasságot ad, de gondos határvonalat kíván a kritikus és a kevésbé érzékeny adatok között.
- Teljes felhő alapú RAG: gyors bevezetést és alacsony kezdeti beruházást tesz lehetővé, de csak akkor javasolt, ha a beszállító adatkezelési gyakorlata és szerződéses garanciái megfelelnek a vállalat compliance-elvárásainak.
A RAG, vagyis a lekérdezéssel kiegészített generálás lényege, hogy a nyelvi modell nem a saját tanítóadatából válaszol, hanem egy előre meghatározott, jogosultságszűrt dokumentumkörből kapja a kontextust, amelyre érdemes odafigyelni a Datenqualität verbessern: Der Praxisleitfaden für Unternehmen tanácsai alapján. Ez csökkenti a hallucináció kockázatát, de csak akkor biztonságos, ha a visszakeresési réteg ugyanazt a jogosultsági logikát érvényesíti, mint a forrásrendszerek. A technikai gerincet egy vektoradatbázis, egy embedding pipeline és egy index frissítési stratégia alkotja: ez utóbbi dönti el, hogy egy frissen módosított dokumentum mennyi idő alatt jelenik meg helyesen a keresési találatok között.
Profi tipp: Mielőtt a modell kiválasztásán gondolkodna, térképezze fel, mely dokumentumtípusoknál a legnagyobb a jogosultsági komplexitás, mert ott dől el, hogy a RAG-réteg valóban biztonságos lesz-e.
Biztonság és megfelelőség: ellenőrzőlista IT-nek és adatvédelemnek
A privát keresés bevezetése adatvédelmi szempontból nem egyszerű technikai projekt, hanem governance-feladat. Az EDPS iránymutatása szerint generatív AI-rendszerek személyes adatokkal végzett működtetésénél érvényesülnek az átláthatóság, az adatminimalizálás és a megőrzési idő alapelvei, és indokolt lehet adatvédelmi hatásvizsgálat, vagyis DPIA elvégzése. A felelősségek egyértelmű azonosítása és a beszállítói átvilágítás ennek szerves része.
A gyakorlati ellenőrzőlista a következő pontokat tartalmazza:
- DPIA elindítása a projekt legelején, nem utólagos jóváhagyásként.
- Adatminimalizálás: csak az adott feladathoz szükséges dokumentumtípusok indexelése, személyes adatok kiszűrése vagy anonimizálása ahol lehetséges.
- Harmadik fél modellek és szolgáltatók átvilágítása szerződéses garanciák, dokumentáció és jogalapok alapján.
- Hozzáférés-vezérlés integrálása a meglévő identitáskezelő rendszerrel (IdP), egyszeri bejelentkezéssel (SSO) és szerep- vagy attribútumalapú jogosultságkezeléssel (RBAC/ABAC).
- Auditálható naplózás minden keresési eseményről, retenciós politikával és rendszeres felülvizsgálattal.
Az EDPB állásfoglalása kiemeli, hogy egy AI-modell anonimnak nyilvánítását esetről esetre kell megítélni, és a legitim érdek jogalapja csak gondos arányossági teszt elvégzése után használható fel személyes adatok feldolgozásához. Ez különösen releváns, ha a privát keresési rendszer e-maileket vagy HR-dokumentumokat is indexel.
A folyamatos monitoring és az incidenskezelési terv ugyanilyen fontos, mint a bevezetéskori ellenőrzés, mert a jogosultsági struktúra idővel változik, és egy rosszul karbantartott index könnyen hozzáférést adhat olyan tartalomhoz, amelyhez a felhasználó már nem lenne jogosult. Az AI rendszereknél alkalmazott incidenskezelés kialakítása éppen ezért nem utólagos lépés, hanem a bevezetési terv része.
Megvalósítási lépések: pilot indítása, mérőszámok és skálázás
A pilot projekt sikere azon múlik, hogy a célok és az elfogadási kritériumok már az induláskor világosak legyenek.
- Határozzon meg egy konkrét üzleti célt a pilothoz, például egy adott osztály dokumentumkeresési idejének csökkentését.
- Válasszon ki egy szűk, jól körülhatárolt adatforrás-kört és a hozzá tartozó jogosultsági struktúrát, hogy a kockázat kezelhető maradjon.
- Rögzítse előre a mérőszámokat: találati relevancia, válaszadási pontosság, válaszidő (latency) és a compliance-ellenőrzések eredménye.
- Végezzen governance-ellenőrzést a pilot előtt és után, beleértve a DPIA frissítését, ha új adattípus kerül be.
- Csak akkor skálázzon tovább, ha a pilot mind az üzleti, mind a megfelelőségi kritériumokat teljesítette.
Az AI pilot projekt indítása lépésről lépésre történő felépítése segít elkerülni, hogy a kezdeti lelkesedés megelőzze a biztonsági felkészültséget. A skálázás előtti utolsó checkpoint mindig a jogosultsági struktúra újbóli átvizsgálása, mert egy pilot során gyakran kiderül, hogy a valós hozzáférési igények eltérnek a papíron rögzítettektől.
Vendor due diligence és a harmadik fél modellek jogi ellenőrzése
Amikor a privát keresési megoldás harmadik fél által fejlesztett modellt vagy felhőalapú szolgáltatást használ, a beszállítói átvilágítás nem opcionális lépés. Az EDPS orientációi kifejezetten kiemelik, hogy generatív AI-rendszerek alkalmazásánál tisztázni kell, ki a felelős az adatkezelésért, és milyen szerződéses garanciák vonatkoznak a beszállítóra.
A gyakorlati átvilágítás a következő kérdésekre keres választ: hol tárolja és dolgozza fel a szolgáltató az adatokat, milyen jogalapon, mennyi ideig őrzi meg a lekérdezéseket, és használja-e azokat további modelltanításra. Az AI Act konszolidált szövege egységes követelményeket fogalmaz meg a biztonságos és átlátható AI-használathoz, és magas kockázatú rendszerek esetén külön kötelezettségeket írhat elő a fejlesztőkre és üzemeltetőkre egyaránt.
A vállalati jogi és IT csapatnak célszerű közösen végigmennie a szerződéses dokumentáción, mielőtt egy harmadik fél modellt bevonnak a belső keresésbe. Ide tartozik az adatfeldolgozói szerződés (DPA) megléte, a biztonsági tanúsítványok ellenőrzése és annak tisztázása, hogy a szolgáltató alvállalkozói kört is bevon-e a feldolgozásba. A GDPR és generatív AI gyakorlati útmutatója részletesen bemutatja, milyen szerződéses pontokra érdemes figyelni ebben a folyamatban.
Költség és üzleti érték: mire számítson a ráfordítások oldalán
A privát keresés bevezetésének költsége több tényezőből áll össze: az infrastruktúra vagy felhőszolgáltatás díja, az indexelési és embedding pipeline kiépítése, a jogosultságkezelési integráció, valamint a folyamatos üzemeltetés és governance. Ezek aránya architektúránként eltér: egy on-prem megoldás magasabb kezdeti beruházást igényel, egy hibrid vagy felhő alapú RAG rendszer alacsonyabb belépési költséggel indul, de folyamatos szolgáltatási díjjal jár.
Az üzleti haszon oldalán a legkönnyebben mérhető tétel a keresési és dokumentumkeresési idő csökkenése, ami közvetlenül átváltható munkaórára. Emellett csökken a duplikált munka kockázata, mert a kollégák nem állítanak elő újra olyan anyagot, ami már létezik a szervezetben, csak korábban nem volt megtalálható. Az adatgyűjtési gyakorlat kialakításánál érdemes azt a elvet követni, hogy a várt üzleti haszon egyértelműen meghaladja a bevezetés adminisztratív és működési terhét, különben a projekt papíron jól hangzik, de a gyakorlatban nem térül meg.
A megtérülés időtávja projektenként eltér, és nagyban függ attól, hány felhasználó és mekkora dokumentumállomány érintett. Egy szűk, jól körülhatárolt pilot alacsonyabb kockázattal teszi lehetővé, hogy a szervezet reális képet kapjon a saját megtérülési görbéjéről, mielőtt nagyobb volumenű beruházásról döntene.
Kiválasztási szempontok a privát keresési megoldások értékeléséhez
A megfelelő megoldás kiválasztásakor érdemes egyszerre vizsgálni a technikai és a megfelelőségi szempontokat, mert egy kiváló keresési pontosságú rendszer is kockázatos, ha hiányzik belőle a jogosultságkezelés. A legfontosabb kritériumok közé tartozik a jogosultságőrzés mélysége, vagyis hogy a rendszer dokumentumszinten vagy akár mezőszinten tudja-e érvényesíteni a hozzáférési szabályokat.
Fontos szempont továbbá az index frissítési sebessége, mert egy elavult index téves vagy elavult találatokat ad, illetve az auditálhatóság mértéke, vagyis hogy minden keresési esemény visszakövethető-e. A beszállító adatkezelési gyakorlata, a szerződéses garanciák és az integrációs képesség a meglévő identitáskezelő rendszerrel szintén döntő tényező. Végül érdemes megnézni, hogy a megoldás mennyire moduláris, tehát bővíthető-e új adatforrásokkal és felhasználói körrel anélkül, hogy újra kellene tervezni a teljes architektúrát.
Gyakorlati üzleti esetek a vállalati tudáskezelésben
A privát keresés leggyakoribb alkalmazási területe a szétszórt dokumentáció egységesítése: szerződések, műszaki specifikációk és belső szabályzatok, amelyek korábban külön megosztott meghajtókon, levelezésben és projektmenedzsment-eszközökben éltek. Gyártó és mérnöki cégeknél jellemző eset, amikor a minőségbiztosítási és gyártási dokumentációt kell gyorsan visszakereshetővé tenni, miközben a hozzáférést osztályonként kell korlátozni.
Egy másik tipikus eset az ügyfélszolgálati tudásbázis, ahol a kollégák korábbi esetmegoldásokat, termékdokumentációt és belső eljárásrendet keresnek egyetlen felületen, jogosultságfüggő szűréssel. A dokumentumfeldolgozás AI-val megoldásai jól mutatják, hogyan válik strukturálttá és kereshetővé egy korábban kezelhetetlen mennyiségű számla- és szerződésállomány. Disztribúciós és logisztikai cégeknél gyakori felhasználási terület a beszállítói szerződések és minőségi előírások gyors visszakeresése egy auditnál vagy ügyfélkérdésnél, ahol a válaszidő közvetlenül befolyásolja az ügyfélkapcsolatot.
Képzés és szervezeti felkészítés a bevezetéshez
A technikailag kifogástalan privát keresési rendszer is kudarcot vallhat, ha a munkatársak nem tudják, hogyan és mire használják. A bevezetés előtt célszerű rövid, gyakorlatorientált képzést tartani arról, milyen típusú kérdéseket érdemes feltenni a rendszernek, és mit jelent, ha egy dokumentum nem jelenik meg a találatok között, mert a felhasználónak nincs hozzáférése.
A szervezeti felkészítés másik fontos eleme a belső kommunikáció arról, hogy a rendszer miért biztonságosabb, mint egy nyilvános AI-eszköz bemásolt vállalati tartalommal. Ez csökkenti annak kockázatát, hogy a munkatársak a hivatalos csatorna helyett saját kezdeményezésű, ellenőrizetlen megoldásokhoz nyúlnak. A vállalati AI szabályzat minta jó kiindulópont ahhoz, hogy a használati szabályok írásban is rögzítve legyenek, és a képzés ne csak szóbeli tájékoztatásra épüljön.
Mikor érdemes külső tanácsadót bevonni?
A legtöbb szervezet alulbecsüli, mennyi jogi és governance kapacitás kell egy privát keresési projekthez, és ezt utólag, a pilot közben fedezi fel, amikor már késő a tervezést átalakítani. Ha a belső csapatból hiányzik a DPIA-tapasztalat vagy a beszállítói szerződések jogi átvilágításának rutinja, egy külső tanácsadó bevonása nem luxus, hanem kockázatcsökkentés.
A valódi érték nem a technológiai eszköz kiválasztásában rejlik, hanem abban, hogy valaki végigviszi a governance-struktúrát a pilot előtt, nem utána próbálja utólag ráhúzni.
— Zsolt
Hogyan segítünk a privát keresés bevezetésében
Üzleti célból indulunk, nem technológiai trendből: először feltérképezzük, mely belső tudásterület okozza a legtöbb elvesztegetett időt, és csak utána tervezzük meg a technikai architektúrát. Vendor-független tanácsadóként nem egy konkrét modellt adunk el, hanem azt a megoldást javasoljuk, amelyik a szervezet jogosultsági és megfelelőségi igényeihez illeszkedik.

Amit konkrétan kínálunk:
- AI Discovery Workshop: feltérképezzük az üzleti KPI-kat és a legnagyobb értékű pilot-jelölteket.
- Kontrollált AI-bevezetés: DPIA-támogatás, beszállítói átvilágítás és pilot felépítés egy kézben.
- Syncbase: moduláris vállalati AI platform.
Ha szeretné tisztán látni, hol térülne meg leggyorsabban egy privát keresési rendszer a szervezetében, kezdje egy AI tanácsadás és stratégia beszélgetéssel.
This article is general information, not a substitute for advice from a qualified lawyer. Consult a qualified legal professional about your own circumstances before acting on anything here.
Gyakran ismételt kérdések
Kötelező DPIA-t készíteni privát keresési rendszerhez?
Akkor kötelező, ha a rendszer személyes adatot is feldolgoz, például e-maileket vagy HR-dokumentumokat indexel. Az EDPS iránymutatása szerint generatív AI-rendszerek ilyen esetben megkövetelik az adatvédelmi alapelvek, köztük a DPIA érvényesítését.
Mennyi idő alatt vezethető be egy pilot privát keresési rendszer?
Az időigény a kiválasztott adatforrás-kör méretétől és a jogosultsági struktúra összetettségétől függ, egy szűken körülhatárolt pilot hetek alatt elindítható. A hosszabb átfutási időt jellemzően a beszállítói átvilágítás és a DPIA elvégzése okozza, nem a technikai telepítés.
Mi a különbség a RAG és a hagyományos kulcsszavas keresés között?
A RAG a lekérdezéshez releváns dokumentumrészeket ad kontextusként egy nyelvi modellnek, amely ezekből fogalmaz meg választ, míg a hagyományos keresés csak dokumentumlistát ad vissza. A RAG csak akkor biztonságos vállalati használatra, ha a visszakeresési réteg érvényesíti ugyanazt a jogosultsági logikát, mint a forrásrendszerek.
Anonimizálni kell az adatokat a privát kereséshez?
Nem minden esetben kötelező, de ahol lehetséges, az adatminimalizálás és az anonimizálás csökkenti a kockázatot. Az EDPB állásfoglalása szerint az anonimnak tekintett adatkezelést is esetről esetre kell megítélni, tehát önmagában nem old meg minden megfelelőségi kérdést.
Legálisan gyűjthetők a nyilvános vállalati dokumentumok egy belső tudásbázisba?
A nyilvános adatok gyűjtése sem mentesít automatikusan az adatvédelmi követelmények alól, különösen ha az adat személyes vonatkozású. A gyakorlati útmutató szerint API-használat, a robots.txt tiszteletben tartása és jogi konzultáció ajánlott, ha bizonytalan az eset.
Források
- Generative AI and the EUDPR. Orientations for ensuring data protection compliance when using Generative AI systems.
- EDPB opinion on AI models: GDPR principles support responsible AI | European Data Protection Board
- Consolidated TEXT: 32024R1689 — EN — 27.07.2026
- Legális a webes adatgyűjtés? Gyakorlati útmutató cégeknek