A modelldrift kezelése három dologból áll: folyamatosan mérni kell, hogyan teljesít a modell éles adatokon, előre rögzíteni kell, mekkora romlásnál kell beavatkozni, és ki kell jelölni, ki dönt és mi történik ilyenkor. Egy AI-modell a bevezetés napján a legjobb formájában van. Utána a piac, a vevők, a beszállítók és a belső folyamatok változnak, a modell viszont a régi világ mintáira emlékszik. Ebben az útmutatóban azt mutatjuk meg, hogyan veszi észre egy magyar kis- vagy középvállalat időben a driftet, mikor érdemes újratanítani, és hogyan lesz a riasztásból üzleti döntés.
TL;DR
- A drift nem programhiba, hanem természetes jelenség: az adatok és az összefüggések idővel elmozdulnak, ezért a modell pontossága csökken.
- Egyetlen mutató nem elég. Kombinálja a teljesítménymérést, az adateloszlás figyelését és a felhasználói visszajelzést.
- Ne fix naptár szerint tanítson újra, hanem akkor, amikor a mérés statisztikailag igazolt romlást mutat.
- A monitorozó felület csak jelez. A kezeléshez előre rögzített felelős, küszöbérték és tartalékmegoldás kell.
- Az EU AI Act a magas kockázatú rendszerek szolgáltatóitól kifejezetten elvárja a forgalomba hozatal utáni nyomon követést.
Tartalomjegyzék
- Mi a modelldrift, és miért nem hiba a rendszerben
- Hogyan jelentkezik a drift egy hazai KKV-nál
- Az észlelés módszerei egymás mellett
- Mikor érdemes újratanítani a modellt
- Kezelési terv lépésről lépésre
- Drift a nyelvi modelleknél és tudásbázis-alapú rendszereknél
- Mit vár el a szabályozás
- A mi nézőpontunk: a figyelés megfigyelés, a kezelés döntés
- Ha most indulna, vagy már fut egy modellje
- Gyakori kérdések
- Források
Mi a modelldrift, és miért nem hiba a rendszerben
A NIST AI kockázatkezelési keretrendszerének útmutatója szerint egy élesbe állított AI-rendszer teljesítménye és megbízhatósága idővel elmozdulhat. Ezt nevezzük driftnek: csökkenti a rendszer értékét a szervezet számára, és növeli a kockázatokat. A modell ilyenkor nem romlik el a szó hagyományos értelmében. Ugyanazt csinálja, mint az első napon, csak a világ már nem ugyanaz.
A szakirodalom két fő típust különböztet meg:
- Adatdrift (data drift): a bemenő adatok eloszlása változik. Például új termékkategóriák jelennek meg a webshopban, vagy egy beszállító más formátumban küldi a számláit.
- Koncepciódrift (concept drift): a bemenet és az eredmény közötti összefüggés változik. Ugyanaz a vásárlói viselkedés mást jelent egy infláció sújtotta évben, mint előtte. Az ACM TOSEM folyóiratban megjelent tanulmány úgy írja le, hogy ilyenkor a célváltozó statisztikai tulajdonságai módosulnak, így a régebbi modellek pontatlanabbá válnak.
A kutatók szerint a drifttel kapcsolatos fogalmak használata következetlen, és ez a döntéshozókat gyakran összezavarja. Mi ezért azt javasoljuk vezetőknek, hogy ne a kategóriákon vitatkozzanak, hanem a hatáson: romlik-e a teljesítmény, és ez mennyibe kerül a cégnek. A típus megnevezése a technikai csapat dolga, az üzleti oldal arra kíváncsi, hogy jó-e még a döntés, amit a modell támogat.
Hogyan jelentkezik a drift egy hazai KKV-nál
A drift ritkán látványos. Inkább lassú erózió, amit hetekig senki nem vesz észre, mert a rendszer továbbra is ad választ. Három tipikus helyzet, amellyel magyar kis- és középvállalatoknál találkozni lehet:
Keresleti előrejelzés a nagykereskedelemben. A modellt két év értékesítési adatán tanították. Aztán árazási változás jön, egy nagy vevő átáll más beszállítóra, vagy megváltozik a szezonális minta. Az előrejelzés még mindig magabiztos számokat ad, de a raktárkészlet egyre többször tér el a valós igénytől. Az első jel nem a modell metrikája, hanem a beszerző panasza.
Intelligens dokumentumfeldolgozás. A számlákat vagy szállítóleveleket automatikusan feldolgozó rendszer jól működik, amíg a partnerek a megszokott formátumot használják. Egy új számlázóprogram, egy átalakított fejléc vagy egy új adómező megjelenése után nő a kézi javítások aránya. Ha ezt senki nem méri, a megtakarítás csendben elolvad.
AI-asszisztens vagy tudásbázis-alapú (RAG) rendszer. Itt a drift gyakran nem a modellben, hanem a forrásanyagban történik: a belső szabályzatok, árlisták, termékleírások frissülnek, a rendszer viszont régi dokumentumokból válaszol. A felhasználók pedig nem jelentik a hibát, egyszerűen abbahagyják a használatot.
Mindhárom esetben közös, hogy a helyes válasz (a „ground truth”) nem érkezik meg azonnal. A TU Delft kutatóinak AIOps-modellek karbantartásáról szóló tanulmánya kifejezetten foglalkozik azzal, hogy a teljesítményromláson alapuló észlelés éles környezetben gyakran nehezen kivitelezhető, mert a valós címkék késve vagy egyáltalán nem állnak rendelkezésre. Ilyenkor helyettesítő mutatókra és az adateloszlás figyelésére kell támaszkodni, tudva, hogy ezek nem mindig mozognak együtt a tényleges hibával.
Az észlelés módszerei egymás mellett
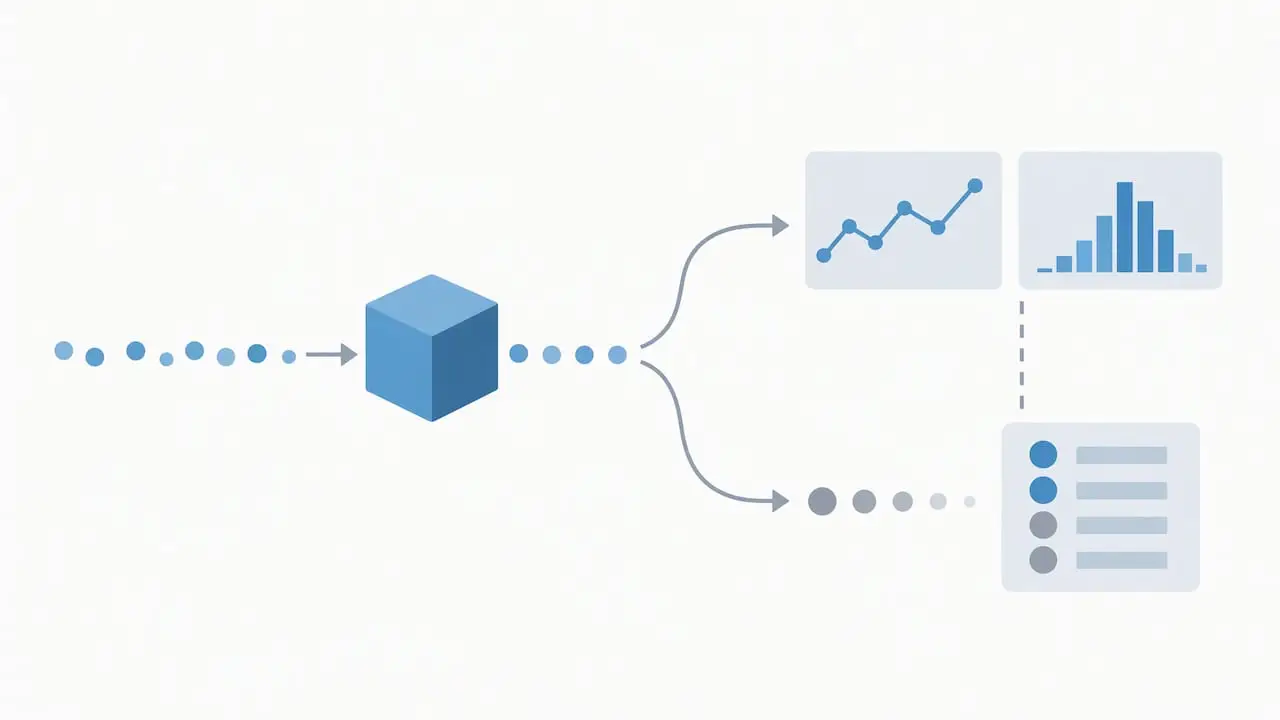
A NIST útmutatója több módszer együttes használatát ajánlja, például statisztikai kontrollhatárokat, konfidenciaintervallumokat és integritási megkötéseket, nem egyetlen mutatót. A gyakorlatban ez rétegzett figyelést jelent:
| Módszer | Mit figyel | Mikor hasznos | Korlátja |
|---|---|---|---|
| Teljesítménymérés (pontosság, hibaarány, eltérés) | A modell kimenetét a valós eredményhez mérve | Ha a valós eredmény néhány napon belül ismert | Késleltetett vagy hiányzó címkéknél nem működik |
| Adateloszlás-figyelés (pl. eloszlások statisztikai összevetése) | A bemenő adatok változását a tanítóadathoz képest | Korai figyelmeztetésként, címkék nélkül is | Nem minden eloszlásváltozás rontja a teljesítményt |
| Hibaalapú driftdetektorok (DDM, STEPD, PERM) | Az előrejelzési hibák alakulását időablakokban | Folyamatos adatfolyamnál, ahol a hibák mérhetők | Statisztikai beállítást és szakértelmet igényel |
| Helyettesítő (proxy) mutatók | Kézi javítások aránya, visszautasított javaslatok, eszkalációk | Dokumentumfeldolgozásnál, asszisztenseknél | Közvetett, értelmezést igényel |
| Felhasználói visszajelzés | Értékelések, panaszok, használati gyakoriság | Generatív és RAG-rendszereknél | Szubjektív, a csend is jelzés lehet |
| Integritási ellenőrzések | Hiányzó mezők, értéktartományon kívüli adatok | Minden rendszernél, alapvédelemként | Csak durva hibákat fog meg |
Az ACM-tanulmány három hibaalapú módszert ír le részletesen. A DDM az előrejelzési hibák alakulását követi, a STEPD azt teszteli, hogy két időablakban azonos-e a pontosság, a PERM pedig véletlen permutációkkal ellenőrzi, stabil-e a modell. Egy KKV-nak ezeket nem kell fejből ismernie, de érdemes tudni, hogy léteznek bevált statisztikai eszközök, és a driftet nem szemre kell megítélni.
A mutatók követéséhez jól átlátható felület kell, amelyet az üzleti oldal is ért. Ha a mérőszámok egy pénzügyi vagy értékesítési riportrendszerben futnak, érdemes megnézni, hogyan lehet a valós idejű riportokat lépésenként bevezetni és a megtérülést mérni: ugyanez a logika érvényes a modell teljesítménymutatóira is.
Mikor érdemes újratanítani a modellt
A leggyakoribb rossz megoldás a naptár szerinti újratanítás: minden hónap elején friss adatokon újratanítják a modellt, függetlenül attól, változott-e bármi. Ez kényelmesnek tűnik, de a modellfrissítési stratégiákat összehasonlító kutatás alapján az érettebb megközelítés az, ha a frissítést igazolt drift váltja ki. A felesleges újratanítás számítási kapacitást visz el, és új instabilitást hozhat a rendszerbe, ha az adatok valójában nem változtak.
A tanulmány a „concept drift guided retraining” megközelítést írja le: amikor a statisztikai teszt megerősíti a driftet, a modellt a legfrissebb adatokon frissítik. A döntéshez négy kérdést érdemes feltenni:
- Valódi-e a változás? Egy rendkívüli hét (akció, ünnep, rendszerleállás) nem drift. Legyen előre megadva, hány egymást követő mérési időszak kell a megerősítéshez.
- Mekkora az üzleti hatás? Egy 2 százalékpontos pontosságcsökkenés az egyik folyamatban elhanyagolható, a másikban jelentős pénzügyi veszteség.
- Van-e elég új, megbízható adat? Az újratanítás csak akkor segít, ha a friss adat már az új helyzetet tükrözi, és megfelelő minőségű.
- Elég-e az újratanítás? Ha az üzleti folyamat alapjaiban változott, előfordulhat, hogy új jellemzők, új modell vagy akár más megoldás kell.
Az újratanított modellt sem szabad ellenőrzés nélkül élesíteni. Érdemes a régi és az új változatot ugyanazon a friss tesztadaton összevetni, és csak akkor váltani, ha az új igazoltan jobb.
Kezelési terv lépésről lépésre
A NIST útmutatója arra is rámutat, hogy a drift kezelése legalább annyira szervezeti feladat, mint technikai. Hiába van kész műszerfal, ha senki nem tudja, ki nézi meg a riasztást, mikor kell leállítani a rendszert, és mi a tartalékmegoldás. Az alábbi lépésekből álló terv egy közepes méretű cégnél is kezelhető:
- Rögzítse a kiindulási állapotot. Mentse el a modell élesítéskori teljesítményét és a tanítóadat fő jellemzőit. Enélkül nincs mihez viszonyítani.
- Válasszon üzleti és technikai mutatókat. Legalább egy mutató legyen, amelyet a vezetés is ért: kézi javítások aránya, előrejelzési eltérés forintban, megválaszolatlan kérdések száma.
- Határozzon meg küszöbértékeket. Két szint működik jól: egy figyelmeztető szint (vizsgálat kell) és egy beavatkozási szint (döntés kell 24 vagy 48 órán belül).
- Jelöljön ki felelőst. Legyen név szerint megnevezett üzleti és technikai gazdája a modellnek. A riasztás nekik szól, nem egy közös postafióknak.
- Írja le a tartalékmegoldást. Mi történik, ha a modellt le kell állítani: visszaállás az előző változatra, kézi feldolgozás, vagy szigorúbb emberi jóváhagyás minden kimenetre.
- Dokumentáljon minden beavatkozást. Mikor, milyen jel alapján, ki döntött, mi lett az eredmény. Ez később a megfelelőség igazolásánál is kell.
- Tartson rendszeres felülvizsgálatot. Negyedévente nézze át, hogy a küszöbök és a mutatók még mindig a valós üzleti kockázatot mérik-e.
A generatív AI-t használó csapatoknál ugyanez a logika érvényes a tartalmi kimenetekre is: a rendszert ember felügyeli, a felelősség nem tolható át a modellre. Erről jó gyakorlati példákat ad egy útmutató a generatív AI felelős használatáról szakmai csapatokban. Ha a drift már üzleti kárt okozott, az a helyzet AI-incidenskezelési kérdés, és érdemes előre tudni, mi a teendő ilyenkor.
Drift a nyelvi modelleknél és tudásbázis-alapú rendszereknél
A nagy nyelvi modelleket használó megoldásoknál a drift másképp néz ki. A cég ritkán tanítja saját maga a modellt, így a változás három forrásból érkezhet: a szolgáltató frissíti az alapmodellt, a belső tudásanyag elavul, vagy a felhasználók kérdései változnak meg.
Ezeknél a rendszereknél az alábbi gyakorlat vált be:
- Rögzített tesztkérdés-készlet: 50–100 valós, ellenőrzött válaszú kérdés, amelyet minden modell- vagy tudásbázis-frissítés után lefuttatnak.
- Forrásfrissesség figyelése: melyik dokumentum mikor frissült, és a rendszer a legújabb változatot használja-e.
- Válaszminőség mintavételes ellenőrzése: hetente néhány tucat választ szakember értékel.
- Jogosultságok ellenőrzése: a tudásbázis bővülésével könnyen előfordul, hogy a rendszer olyan anyaghoz is hozzáfér, amelyhez nem kellene. Erről szól az AI-ügynökök jogosultságainak rendbetételéről szóló cikkünk.
Mit vár el a szabályozás
Az EU AI Act 72. cikke előírja, hogy a magas kockázatú AI-rendszerek szolgáltatói forgalomba hozatal utáni nyomonkövetési rendszert működtessenek. Ennek a rendszer teljes élettartama alatt szisztematikusan gyűjtenie, dokumentálnia és elemeznie kell a teljesítményadatokat, a nyomonkövetési terv pedig a műszaki dokumentáció része. A Bizottságnak 2027. szeptember 2-ig kell sablont és iránymutatást kiadnia ezekhez a tervekhez.
A határidők közben módosultak: a Digital Omnibus csomag eltolja a magas kockázatú AI-rendszerekre vonatkozó kötelezettségek határidejét, többek között a toborzásban vagy oktatásban használt rendszerekre. A halasztás azonban csak időt ad, a feladatot nem veszi le a cégekről. Aki most épít ki driftfigyelést, az a későbbi megfelelés alapjait is lerakja. A magyar cégeket érintő részletekről az AI Act hatásairól szóló összefoglalónkban írtunk.
A nem magas kockázatú rendszereknél nincs ilyen jogi kötelezettség, de az üzleti kockázat ugyanúgy fennáll. A NIST 2026 márciusában kiadott jelentése az élesített AI-rendszerek monitorozásának kihívásairól hiányosságként emeli ki például az ember és AI közötti visszajelzési körök kevéssé kutatott voltát. A teljes NIST AI 800-4 dokumentum azt is jelzi, hogy a monitorozásra még nincsenek kiforrott bevált gyakorlatok és közös terminológia. Vagyis a driftkezelés ma tudatos szervezeti döntés, nem polcról levehető megoldás.
A mi nézőpontunk: a figyelés megfigyelés, a kezelés döntés
Amikor ügyfeleinkkel AI-megoldást vezetünk be, a driftkezelést nem a projekt végén csatoljuk hozzá, hanem az első workshopon kezdjük el tervezni. Ennek egyszerű oka van: amit nem mérünk a bevezetés előtt, azt utána sem tudjuk értelmesen összehasonlítani.
Azt látjuk, hogy a cégek nem a technikai eszközök hiánya miatt kerülnek bajba. Monitorozó felület ma szinte minden platformon van. A gond az, hogy a riasztás megjelenik, de senki nem tudja, kinek kellene vele foglalkoznia, és milyen döntést hozhat. A műszerfal megfigyel, a kezelést viszont emberek végzik, előre rögzített szabályok szerint.
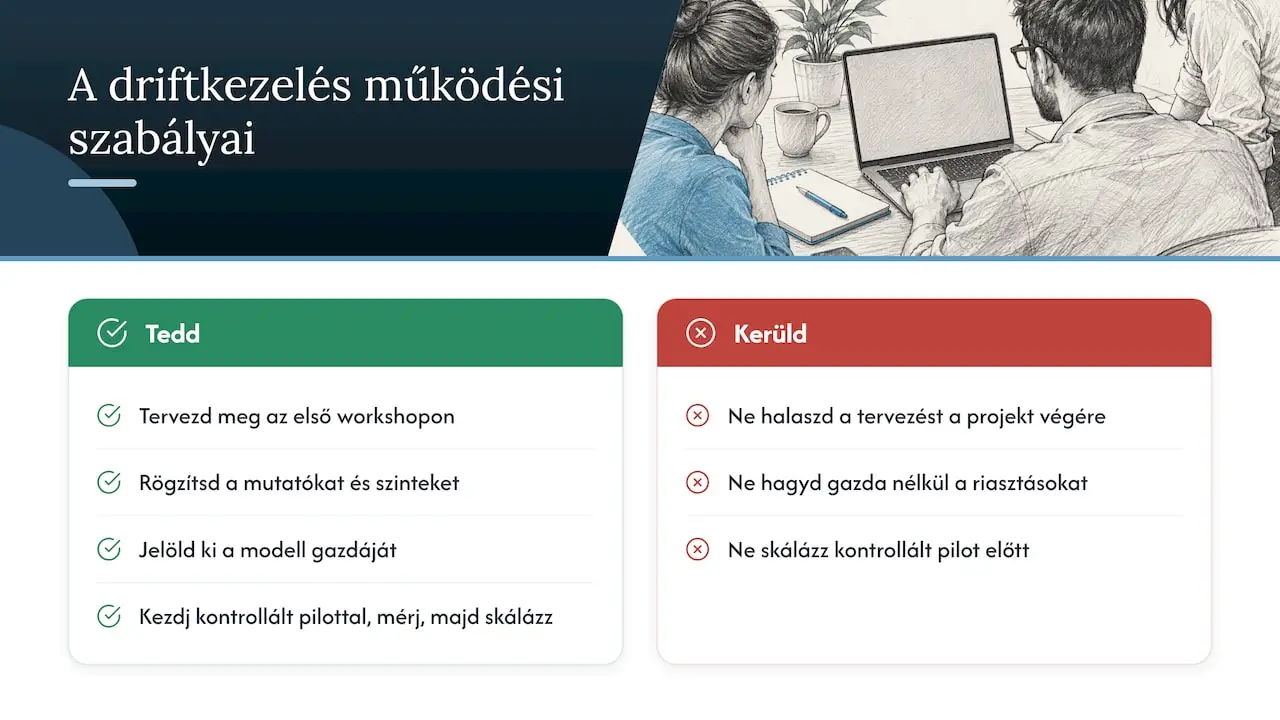
Ezért nálunk minden élesített megoldáshoz tartozik egy rövid, közérthető működési szabály: milyen mutatókat nézünk, mi a figyelmeztető és a beavatkozási szint, ki a modell gazdája, és mi a visszaállási terv. Az emberi felügyeletet, a naplózást és az auditálhatóságot a megoldás részének tekintjük, nem utólagos kiegészítésnek. Ugyanígy fokozatos élesítést javaslunk: előbb kontrollált pilot, mért eredményekkel, és csak utána skálázás.
Vendorfüggetlenül dolgozunk, így nem egy adott eszközt akarunk eladni a driftfigyelésre. Azt választjuk, ami a cég meglévő rendszereibe illik, és amit a csapat hosszú távon fenn tud tartani.
— Zsolt
Ha most indulna, vagy már fut egy modellje
Ha még csak tervezi az AI-bevezetést, az AI Discovery Workshop jó kiindulópont: egyszeri, 390 000 Ft-os alkalom, ahol az üzleti célokból kiindulva azonosítjuk és rangsoroljuk a lehetőségeket, és már itt meghatározzuk, mit és hogyan kell majd mérni. Ha már működik egy modell, de nem tudja, mennyire megbízható ma, az AI-optimalizálás és átvilágítás, valamint a megoldások üzemeltetése szolgáltatásunk ebben segít. A szélesebb keretekről az AI governance szabályozási kérdéseiről szóló cikkünkben olvashat.
Gyakori kérdések
Milyen gyakran kell ellenőrizni egy modellt drift szempontjából?
A folyamat ütemétől függ. Napi tranzakciókat feldolgozó rendszernél a technikai mutatókat érdemes naponta vagy hetente automatikusan figyelni, az üzleti felülvizsgálatot pedig havonta vagy negyedévente elvégezni. A lényeg, hogy a figyelés folyamatos legyen, a beavatkozás pedig küszöbértékhez kötött.
Mi a különbség az adatdrift és a koncepciódrift között?
Adatdriftnél a bemenő adatok változnak, például új termékek vagy új dokumentumformátumok jelennek meg. Koncepciódriftnél a bemenet és az eredmény közötti összefüggés változik meg, például más vásárlói viselkedés vezet ugyanahhoz a döntéshez. Üzleti szempontból a fontosabb kérdés az, hogy romlik-e a teljesítmény, és mennyibe kerül ez.
Elég, ha havonta újratanítjuk a modellt?
Általában nem ez a legjobb megoldás. A fix ütemű újratanítás felesleges költséget és instabilitást okozhat, ha az adatok valójában nem változtak. Érettebb megközelítés, ha a frissítést mért, statisztikailag igazolt romlás indítja el, és az új változatot élesítés előtt a régihez mérik.
Kell-e driftfigyelés, ha nem magas kockázatú rendszert használunk?
Jogi kötelezettség az AI Act alapján elsősorban a magas kockázatú rendszerek szolgáltatóit terheli. Üzletileg viszont minden élesített modellnél indokolt, mert a drift csendben rontja a megtérülést. Egy egyszerű, néhány mutatóra épülő figyelés és egy kijelölt felelős már sokat segít.
Források
- NIST AI RMF Playbook: Manage
- On the Model Update Strategies for Supervised Learning in AIOps Solutions (ACM TOSEM)
- Concept drift terminológiai áttekintés (Knowledge-Based Systems)
- Maintaining and Monitoring AIOps Models Against Concept Drift (CAIN 2023)
- AI Act 72. cikk: forgalomba hozatal utáni nyomon követés
- Digital Omnibus: halasztás az AI Act magas kockázatú szabályaiban (Jogi Fórum)
- NIST: New Report: Challenges to the Monitoring of Deployed AI Systems
- NIST AI 800-4: Challenges to the monitoring of deployed AI systems