A magyar nyelvű beszédfelismerés ma már elég jó ahhoz, hogy egy hazai kkv ügyfélszolgálati hívásokat, értekezleteket vagy terepen diktált jegyzeteket alakítson vele kereshető szöveggé. Önmagában a pontosság mégsem dönti el, hogy egy projekt sikeres lesz-e. Ugyanennyit nyom a latban, hogy melyik folyamatban használják, ki ellenőrzi a kimenetet, hol tárolják a hangot, és milyen jogalapon dolgozzák fel. Ebben a cikkben végigvesszük, hol térül meg a technológia, mennyire bírja a magyar spontán beszédet, milyen megoldástípusok közül választhat, mit mond róla a magyar jogi gyakorlat 2026-ban, és hogyan vezetheti be úgy, hogy a végén mérhető eredmény legyen, ne adatvédelmi eljárás.
Röviden
- A beszédfelismerés ott hoz a legtöbbet, ahol sok a hanganyag és kevés az idő a feldolgozására: ügyfélszolgálat, értekezlet-összefoglalók, terepi dokumentáció.
- Felolvasott magyar szövegen a pontosság kiváló, a spontán, egymás szavába vágó beszéd viszont még mindig sokkal nehezebb feladat, ezért a kritikus átiratokat embernek kell ellenőriznie.
- Munkahelyi környezetben a munkavállalói hozzájárulás általában nem megfelelő jogalap: dokumentált érdekmérlegelés kell, a nyers hangot pedig rövid határidőn belül törölni kell.
- Az AI Act tiltja, hogy a rendszer a hangból a munkavállalók érzelmeire következtessen, ezt a funkciót le kell kapcsolni.
- Az eszköz kiválasztása a második lépés. Az első az üzleti cél, a mérőszám és a governance-szabályok rögzítése.
Tartalomjegyzék
- Hol hoz valódi üzleti értéket a beszédfelismerés
- Mennyire érti a gép a magyar beszédet
- Milyen megoldástípusok közül választhat
- Mit enged a magyar jog és az AI Act
- Az átirat nem hiteles jegyzőkönyv
- Bevezetés lépésről lépésre
- A mi nézőpontunk
- Gyakori kérdések
- Források
Hol hoz valódi üzleti értéket a beszédfelismerés
A beszéd-szöveg átalakítás nem önálló termék, hanem egy folyamat része. Akkor érdemes vele foglalkozni, ha meg tudja nevezni azt a munkafolyamatot, amelyben ma valaki kézzel jegyzetel, visszahallgat vagy gépel. A magyar kkv-knál leggyakrabban ezek kerülnek elő:
- Ügyfélszolgálati hívások feldolgozása. A hívások átirata alapján automatikusan készülhet összefoglaló, kategória és teendőlista a CRM-be. Az ügyintéző nem a jegyzeteléssel tölti a hívás utáni perceket, a vezető pedig a gyakori panasztípusokat egyetlen kimutatásban látja.
- Értekezlet-összefoglalók. Projektmegbeszélések, vezetői értekezletek döntéseinek és felelőseinek rögzítése. Itt a teljes szó szerinti leirat helyett jellemzően a rövid, ellenőrzött összefoglaló a jobb és jogilag is biztonságosabb kimenet (erről lentebb részletesen írunk).
- Terepi és műszaki dokumentáció. Szervizes kollégák, karbantartók, minőségellenőrök a munka közben, kesztyűben is tudnak diktálni. A szöveg strukturált űrlapba kerül, nem egy hangfájlokkal teli mappába.
- Belső tudás megőrzése. Oktatások, szakmai prezentációk és átadás-átvételi beszélgetések átirata bekerülhet egy vállalati tudástárba, ahol később kereshető. Hogy ez hogyan épül fel, azt a vállalati AI tudástár építéséről szóló cikkünkben mutatjuk be.
- Dokumentumfeldolgozás előkészítése. Hangüzenetek, telefonos megrendelések, diktált ajánlatkérések átirata után egy nyelvi modell kinyeri a lényeges adatokat (termék, mennyiség, határidő), és továbbítja az ERP-be.
A közös pont: az érték nem az átiratból, hanem abból születik, ami utána történik vele. Ha a szöveg egy mappában landol és senki nem olvassa el, a projekt csak költséget termel.
Mennyire érti a gép a magyar beszédet
A magyar nehéz nyelv a beszédfelismerőknek. A toldalékoló szerkezet miatt egy szótőnek rengeteg alakja van, a szórend szabad, és a hétköznapi beszédben gyakoriak az összevont, elharapott alakok. Ehhez jön a vállalati közeg: szakszavak, terméknevek, angol kifejezések keverése, és a rossz minőségű telefonos vagy laptopmikrofonos hang.
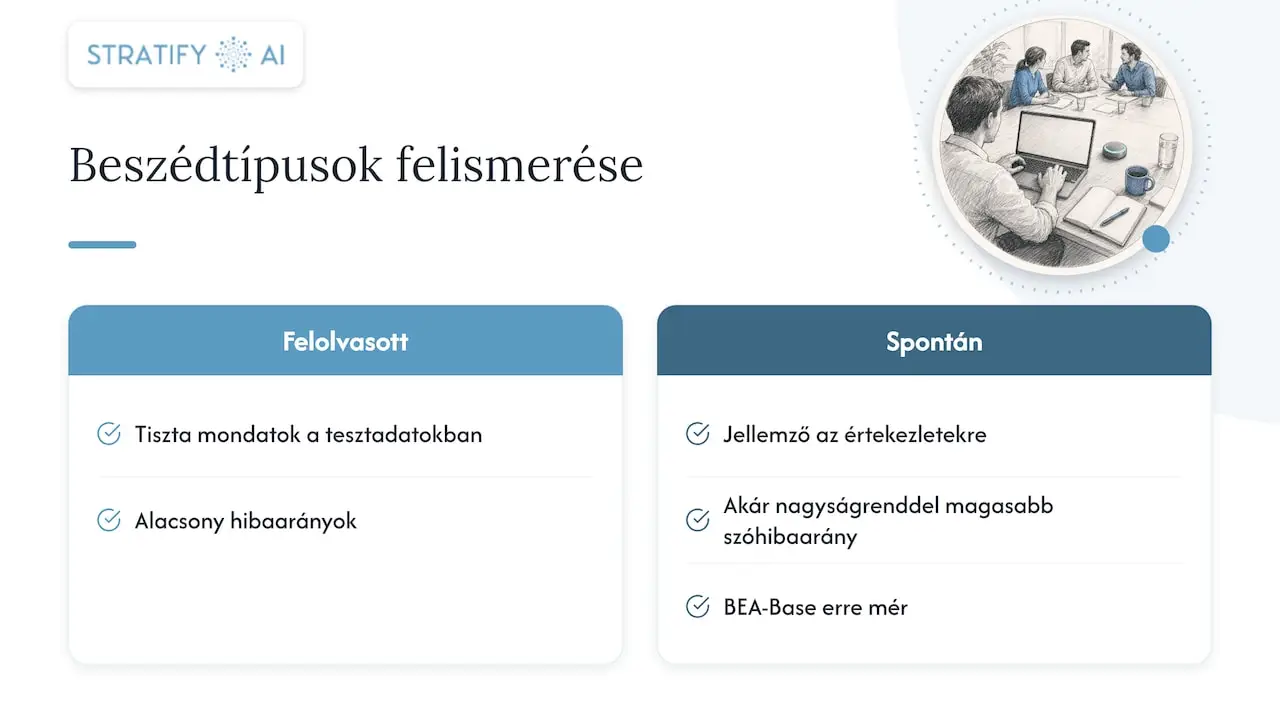
A legfontosabb különbség a felolvasott és a spontán beszéd között van. A tesztadatkészletek többsége tiszta, felolvasott mondatokat tartalmaz, és a szolgáltatók ezeken mért, igen alacsony hibaarányokat szoktak közölni. Egy értekezlet viszont nem felolvasás. A Beszédtudomány folyóiratban megjelent magyar kutatás a spontán beszéd felismeréséről szerint a spontán magyar beszéd szóhibaaránya akár egy nagyságrenddel magasabb lehet, mint a felolvasott szövegé. Ezért hozták létre a kutatók a BEA-Base adatkészletet, amely kifejezetten a spontán magyar beszéd felismerésének mérésére szolgál, mivel korábban ilyen nyilvános referencia gyakorlatilag nem létezett.
A gyakorlati tapasztalat is ezt mutatja. Egy 2026-os hazai teszt öt hangfelismerő platformról azt vizsgálta, mennyire könnyű elindítani őket, milyen gyorsan készül el az átirat, és mennyire pontos. Az eredmények eszközönként jelentősen eltértek. A nagy globális felhőszolgáltatások jellemzően jobban teljesítenek, mint az általános, finomhangolatlan nyílt forráskódú modellek.
Mit jelent ez önnek? Ne a gyártói adatlapra hagyatkozzon, hanem a saját hanganyagán mérjen. Válasszon ki 20–30 valódi, anonimizált felvételt (ügyfélhívást, értekezletrészletet, diktálást), készíttessen róluk kézi referenciaátiratot, és ezen hasonlítsa össze a jelölteket. Figyeljen különösen a nevekre, számokra, dátumokra és a cégspecifikus szakszavakra, mert az üzleti kár többnyire ezeknél keletkezik, nem a töltelékszavaknál.
Milyen megoldástípusok közül választhat
A piacon négy fő megközelítés létezik. Egyik sem jó minden helyzetre, a választás az adatérzékenységtől, a hangmennyiségtől és az integrációs igénytől függ.
| Megoldástípus | Erősség | Gyengeség | Mikor jó választás |
|---|---|---|---|
| Globális felhőalapú beszédfelismerő API | Erős általános pontosság, gyors indulás, sok nyelv | Az adat külső szolgáltatóhoz kerül, a szerződési és adattárolási feltételeket külön kell vizsgálni | Kevésbé érzékeny hanganyag, gyors kísérlet |
| Nyílt forráskódú modell saját szerveren | Teljes adatkontroll, nincs hívásonkénti díj | Saját üzemeltetés, GPU-igény, finomhangolás nélkül gyengébb magyar pontosság | Érzékeny adat, házon belüli IT-kapacitás |
| Hazai, magyarra specializált dobozos szoftver | Magyar nyelvre optimalizált, egyszerű használat | Korlátozott integráció a saját rendszerekkel, kötött funkciók | Feliratozás, egyéni diktálás, tartalomgyártás |
| Egyedi, integrált megoldás | A cég folyamataihoz, rendszereihez és governance-szabályaihoz igazodik | Előzetes felmérést és pilotot igényel | Ha az átiratnak CRM-be, ERP-be vagy tudástárba kell futnia, ellenőrzött módon |
A beszédfelismerő motor ma már inkább alapanyag, mint végtermék. A különbséget az adja, ami köré épül: a szakszótár, az emberi ellenőrzési lépés, a jogosultságkezelés, a naplózás és az integráció. Az adatbiztonság AI projektekben témájáról szóló útmutatónk részletesen leírja, milyen kérdéseket tegyen fel egy külső szolgáltatónak, mielőtt hangfelvételt küld hozzá.
Mit enged a magyar jog és az AI Act
A beszédfelismerés a hang miatt különösen érzékeny terület: a hangfelvétel személyes adat, a leirat pedig névhez rendelt, kereshető, gépileg elemezhető szöveg. A magyar jogi gyakorlat 2026-ra elég világos kereteket rajzolt ki.
Jogalap: érdekmérlegelés a hozzájárulás helyett
A Magyar Kereskedelmi és Iparkamara oldalán közzétett jogi állásfoglalás a munkahelyi telekonferenciák MI-alapú leiratozásáról szerint sem a GDPR, sem a Munka Törvénykönyve nem tiltja a leiratozást, de szigorú feltételekhez köti. A dokumentum szerint a munkáltató a rendszeres leiratozást nem alapozhatja a munkavállalók általános hozzájárulására. A munkaviszonyban fennálló függőség miatt ugyanis a hozzájárulás nem tekinthető valóban önkéntesnek. Helyette dokumentált érdekmérlegelésre van szükség, amely megindokolja, miért szükséges a feldolgozás, és miért nem érhető el a cél kevésbé beavatkozó módon. Ha a téma tágabb, értékesítési oldalát is látni szeretné, az AI-alapú értekezletelemzés döntéshozói ellenőrzőlistája segít végiggondolni, mit és milyen mérőszámokkal érdemes egyáltalán rögzíteni.
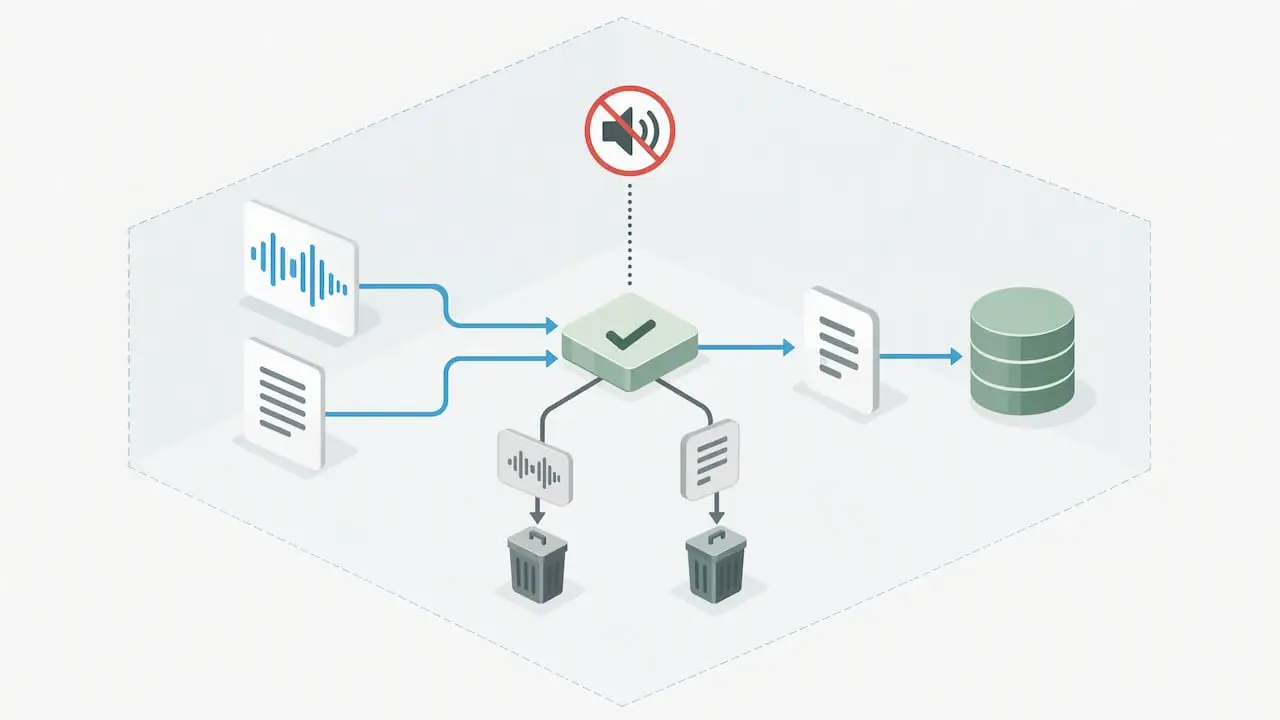
Az állásfoglalás alapértelmezésként az automatikus összefoglalót javasolja a belső értekezletekre. A teljes, szó szerinti leirat jogilag kockázatosabb, ezért csak előre meghatározott értekezlettípusoknál indokolt, ahol a pontos szöveg valódi üzleti szükséglet.
Adatmegőrzés és kockázatos funkciók
Ugyanez az állásfoglalás azt ajánlja, hogy a nyers hangfelvételt és a nyers leiratot néhány munkanapon belül törölni kell, miután egy ember jóváhagyta a végleges összefoglalót. Az IT-vezetőknek a helyben telepített vagy privát felhős környezetet javasolja. A hangalapú biometrikus beszélőazonosítást pedig a magas kockázatú funkciók közé sorolja, amelyet érdemes letiltani.
Érzelemfelismerés: tiltott a munkahelyen
Az EU mesterséges intelligenciáról szóló rendelete, az AI Act 5. cikke tiltja azokat a rendszereket, amelyek munkahelyen a hangból, hangszínből vagy hangerőből következtetnek a munkavállalók érzelmeire. Kivételt csak az orvosi vagy biztonsági célok jelentenek. A Wolters Kluwer munkajogi blogjának elemzése a munkahelyi érzelemfelismerés tilalmáról részletesen bemutatja, mit jelent ez a gyakorlatban. Az Európai Bizottság AI Act ügyfélszolgálata pedig összefoglalja az 5. cikk teljes tiltólistáját. Sok hívásközponti szoftverben „hangulatelemzés” vagy „elkötelezettségi pontszám” néven fut ilyen funkció. Bevezetés előtt kérje meg a szállítót, hogy írásban nevezze meg, mely funkciók vannak kikapcsolva. A rendelet hazai vonatkozásait az AI Act magyar cégekre gyakorolt hatásáról szóló cikkünkben foglaltuk össze.
A NAIH már vizsgált ilyen esetet
A téma nem elméleti. A Nemzeti Adatvédelmi és Információszabadság Hatóság egy pénzintézettel szemben hivatalból indított eljárást az MI-alapú beszédjel-feldolgozás miatt. A bank ügyfélszolgálati hívásokat elemzett automatikusan, többek között az ügyfelek érzelmi állapotára vonatkozóan. A határozat jól mutatja, hogy a hatóság a hangelemzés célját, átláthatóságát és az érdekmérlegelés minőségét is vizsgálja, nem csak azt, hogy van-e adatkezelési tájékoztató.
Az átirat nem hiteles jegyzőkönyv
A Magyar Ügyvédi Kamara Elnöksége a 4/2026. (VII. 13.) számú szakmai álláspontjában rögzítette, hogy az AI-átirat nem minősül hiteles jegyzőkönyvnek. Az álláspont szerint az MI-alapú átírás a felvételtől független, önálló adatkezelési művelet: külön adatvédelmi hatásvizsgálatot igényel, és a rögzített adat nem használható modelltanításra. Bár a dokumentum ügyvédeknek szól, a logikája bármely vállalatra átvihető, ahol az átiratból döntés, szerződés vagy ügyfélnek küldött dokumentum születik.
A gyakorlatban ez egy kötelező emberi ellenőrzési lépést jelent, amely legalább ezekre terjed ki:
- Nevek, cégnevek és megszólítások egyezése.
- Számok, összegek, mennyiségek és mértékegységek.
- Dátumok, határidők és időpontok.
- Tagadások: a „nem vállaljuk” és a „vállaljuk” közötti különbség egyetlen elhallott szón múlhat.
- A döntések és felelősök helyes hozzárendelése.
Az ellenőrzés felelősét név szerint érdemes kijelölni, és a jóváhagyást naplózni. A HR-szempontokat, vagyis azt, hogyan készítse fel a munkatársakat az új szerepre, az AI a HR-folyamatokban témájú gyakorlati útmutató jól összefoglalja szakembereknek és vezetőknek.
Bevezetés lépésről lépésre
A beszédfelismerő projekt ugyanúgy bukhat el, mint bármely más AI-projekt: ha az eszközzel kezdődik, nem a problémával. Az alábbi sorrend csökkenti a kockázatot.
- Üzleti cél és mérőszám. Melyik folyamatot gyorsítja, és mennyivel? Például: a hívás utáni adminisztráció ideje, az értekezlet utáni összefoglaló elkészülésének ideje, a CRM-bejegyzések hiányossága.
- Adatleltár és jogalap. Milyen hang keletkezik, kié, hol tárolódik? Készüljön érdekmérlegelés és adatvédelmi hatásvizsgálat, és frissüljön a munkavállalói és ügyféltájékoztató.
- Belső szabályzat. Melyik értekezletet szabad rögzíteni, ki fér hozzá az átirathoz, mikor törlődik a hang? A vállalati AI szabályzat mintája jó kiindulópont.
- Mérés a saját hanganyagon. 20–30 referenciafelvétel alapján hasonlítsa össze a megoldástípusokat a nevek, számok és szakszavak pontossága szerint.
- Korlátozott pilot. Egy csapat, egy folyamat, 6–12 hét, előre rögzített sikerkritériumokkal. A felépítést az AI pilot projekt indításáról szóló cikkünk lépésenként írja le.
- Integráció és ellenőrzés. Az átirat vagy összefoglaló a meglévő rendszerbe fut (CRM, ERP, tudástár), emberi jóváhagyási ponttal és naplózással.
- Skálázás és folyamatos kontroll. Rendszeres mintavételes pontosságmérés, a szakszótár bővítése, a törlési szabályok betartásának ellenőrzése.
Ha még nem világos, melyik folyamatban érdemes elkezdeni, az AI Discovery Workshopunk erre való. Egyszeri, 390 000 Ft-os díjért közösen azonosítjuk és ROI szerint rangsoroljuk a cég AI-lehetőségeit, a beszédfelismerést is beleértve. Ha a cél már megvan, a kontrollált AI-bevezetés keretében lehetőségfelméréssel és pilottal visszük végig a projektet. A jogi és szabályzati oldalt AI compliance szolgáltatásunk fedi le.
A mi nézőpontunk
A beszédfelismerésről szóló beszélgetések többsége azzal kezdődik, melyik eszköz a legpontosabb magyarul. Ez fontos kérdés, de szerintünk nem az első. Azt látjuk, hogy a megtérülést nem a motor néhány százalékpontnyi pontosságkülönbsége dönti el, hanem az, hogy az átirat bekerül-e egy működő folyamatba, és van-e valaki, aki felel érte.
Ezért nálunk minden ilyen projekt az üzleti céllal és a mérőszámmal indul, és csak utána jön a technológia. Gyártófüggetlenül dolgozunk, így a megoldástípust az adatérzékenység és a meglévő rendszerek alapján választjuk, nem egy termék eladása miatt. A governance-t, az adatbiztonságot, az emberi felügyeletet és a naplózást a megoldás részének tekintjük, nem utólagos kiegészítésnek. Egy beszédfelismerő rendszer, amely érzelmeket elemez, a nyers hangot hónapokig őrzi, és amelynek átiratait senki nem ellenőrzi, a tökéletes pontosság mellett is rossz megoldás.
A kkv-knak azt javasoljuk: kezdjenek kicsiben, egy jól mérhető folyamattal. Az összefoglaló legyen az alapértelmezés, a szó szerinti leirat a kivétel, és a pilot eredménye alapján döntsenek a folytatásról, ne a lelkesedés alapján.
— Zsolt
Gyakori kérdések
Rögzíthetem és leiratozhatom a munkatársak értekezleteit a hozzájárulásukkal?
Rendszeres leiratozásnál a hozzájárulás általában nem megfelelő jogalap, mert a munkaviszonyban nem tekinthető valóban önkéntesnek. Helyette dokumentált érdekmérlegelésre és megfelelő tájékoztatásra van szükség. A konkrét esetet adatvédelmi szakjogásszal vagy a cég adatvédelmi tisztviselőjével érdemes átnézetni.
Mennyire pontos a magyar beszédfelismerés egy valódi értekezleten?
Felolvasott, tiszta hangon nagyon pontos, spontán, egymásba vágó beszédnél viszont a hibaarány akár egy nagyságrenddel magasabb lehet. A rossz mikrofon, a háttérzaj és a szakszavak tovább rontják az eredményt. Ezért a saját hanganyagon mért teszt többet ér bármely gyártói adatnál.
Használhatok hangulatelemzést az ügyfélszolgálaton?
A munkavállalók érzelmeinek hang alapján történő felismerését az AI Act a munkahelyen tiltja, kivéve az orvosi vagy biztonsági célokat. Az ügyfelek hangjának elemzése is komoly adatvédelmi kockázat, ahogy a NAIH egyik bankkal szembeni eljárása is mutatja. Bevezetés előtt ezt a funkciót érdemes kikapcsolni, és jogi szakértővel átvilágíttatni.
Felhőben vagy saját szerveren futtassuk a beszédfelismerést?
Kevésbé érzékeny hanganyagnál a felhő gyors és pontos indulást ad, ha a szerződés kizárja a modelltanítást, és rögzíti az adattárolás helyét. Érzékeny belső értekezleteknél a helyi vagy privát felhős futtatás biztonságosabb. A döntés az adatosztályozáson múlik, nem az árajánlaton.
Források
- Beszédtudomány: spontán magyar beszéd felismerése
- BEA-Base: A Benchmark for ASR of Spontaneous Hungarian
- Kipróbáltuk a legnépszerűbb AI hangfelismerő alkalmazásokat
- MKIK: Készíthet-e mesterséges intelligencia segítségével leiratot a munkáltató?
- Wolters Kluwer: The Prohibition of AI Emotion Recognition Technologies in the Workplace
- AI Act Service Desk: tiltott rendszerek az 5. cikk szerint
- NAIH-85-3/2022 határozat
- Magyar Ügyvédi Kamara 4/2026. (VII. 13.) számú szakmai álláspontja
- AI a HR-folyamatokban
- AI-alapú értekezletelemzés