Az AI-adatirányítás szabályok, felelősök és ellenőrzések összessége. Ezek döntik el, milyen adathoz férhet hozzá egy mesterségesintelligencia-rendszer, ki felel az adat minőségéért és jogszerű használatáért, hogyan védik, és utólag hogyan lehet visszakövetni, mi történt vele. Egy középvállalatnál ehhez nem kell új osztály. Elég egy adatleltár, néhány kijelölt felelős, pár írásba foglalt szabály, ellenőrzések, amelyeket a rendszer maga kényszerít ki, és rendszeres felülvizsgálat. Az alábbiakban végigvesszük, mit várnak el a magyar és az uniós szabályok, kinek mi a dolga a szervezetben, és milyen sorrendben érdemes nekikezdeni.
Röviden
- Az AI-projektek többsége az adatokon bukik el, nem a modellen: a Gartner előrejelzése szerint 2026 végéig az AI-projektek 60 százalékát leállíthatják, mert nem megfelelő adatokra épülnek.
- Az AI-adatirányítás az adatok teljes útjára kiterjed: a bemenetekre, a visszakeresett dokumentumokra, a naplókra, a tanítóadatokra és a kimenetekre is.
- A GDPR már ma minden személyes adatot kezelő AI-megoldásra vonatkozik. Az EU AI Act adatkormányzási követelményei a nagy kockázatú rendszereket érintik, ezek alkalmazása későbbre tolódott.
- Középvállalati méretben a kulcs a világos felelősség: minden adatkörnek legyen üzleti gazdája, és az adatvédelem, az IT és az információbiztonság együtt hagyja jóvá a felhasználást.
- Hat lépés elég az induláshoz: felhasználási eset, adatleltár, minőségmérés, jogalap és kockázat, technikai kontrollok, dokumentáció és felülvizsgálat.
Tartalomjegyzék
- Mit jelent az AI-adatirányítás a gyakorlatban
- Miért bukik el az AI-projekt rendezetlen adatokon
- Az adatminőség szempontjai AI-projektekben
- Szabályok: GDPR, AI Act és a magyar végrehajtás
- Ki felel az adatokért középvállalati méretben
- Az adatirányítás bevezetése hat lépésben
- Dokumentáció és rendszeres felülvizsgálat
- A mi nézőpontunk
- Hol érdemes elkezdeni
- Gyakori kérdések
- Források
Mit jelent az AI-adatirányítás a gyakorlatban
A klasszikus adatirányítás (angolul data governance) arról szól, hogy a vállalat adatai pontosak, elérhetők és védettek legyenek. Az AI ezt két ponton bővíti ki. Egyrészt az adat itt nemcsak tárolódik és megjelenik egy riportban, hanem a rendszer viselkedését is meghatározza. Másrészt az AI olyan új adatfolyamokat hoz létre, amelyekre a korábbi szabályzatok nem gondoltak.
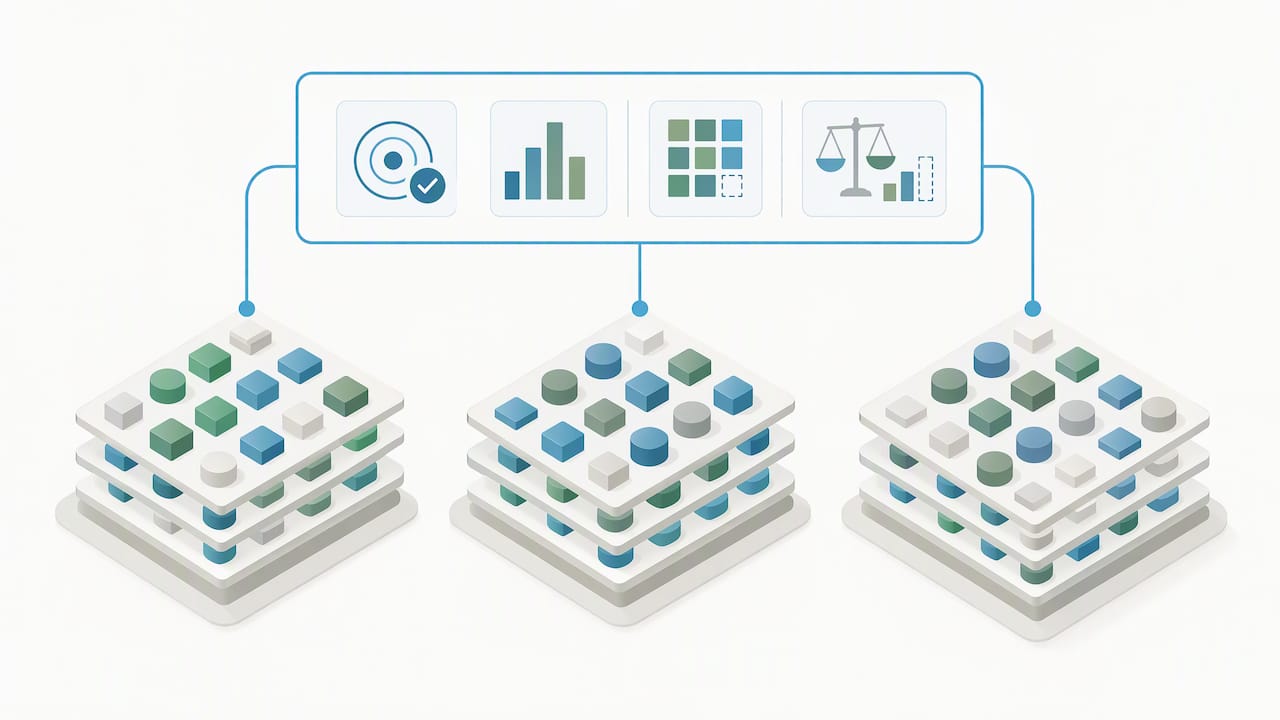
Egy tipikus vállalati AI-asszisztens vagy tudásmenedzsment-rendszer (RAG) esetén legalább öt adatréteget kell kezelni:
- Bemenet: amit a munkatárs begépel vagy feltölt, például egy ügyfél szerződését vagy egy reklamációs e-mailt.
- Visszakeresett dokumentumok: amit a rendszer a belső tudásbázisból a válaszhoz előhív.
- Naplók: a kérdések, válaszok és hozzáférések nyomai, amelyek maguk is személyes adatot tartalmazhatnak.
- Tanító- és finomhangoló adatok: ha a modellt saját adatokon tanítják vagy hangolják.
- Kimenet: a generált szöveg, besorolás vagy javaslat, amely üzleti döntésbe kerül.
Az uniós mesterséges intelligenciáról szóló rendelet magyar szövege az „adatkormányzás” szót használja. A hazai szakmai nyelvben az adatirányítás és az adatgazdálkodás is elterjedt, a három lényegében ugyanazt a feladatot jelöli.
Az OECD AI-felkészültségi útmutatója szerint a jó adatirányítás folyamatos működési fegyelem, nem egyszeri adattisztítás. Az adatminőséget, az adatvédelmet, a szellemi tulajdont, a biztonságot, a torzítást, a sokféleséget és a nyomonkövethetőséget együtt kell kezelni. Ez a gyakorlatban azt jelenti, hogy az adatirányítás nem a projekt végén elvégzendő megfelelőségi ellenőrzés, hanem az első munkanaptól része a tervezésnek.
Miért bukik el az AI-projekt rendezetlen adatokon
A Fintech.hu elemzése jól összefoglalja a lényeget: a technológia a nem egységes folyamatokat és a rosszul kezelt adatokat nem kijavítja, hanem felerősíti. Amit egy ember a saját tapasztalata alapján kiszűr („ez a tavalyi árlista, ezt már nem használjuk”), azt az AI-asszisztens ugyanolyan magabiztosan idézi, mint a friss változatot.
Néhány hiba, amellyel középvállalati projektekben rendszeresen találkozni:
- Párhuzamos dokumentumváltozatok. Ugyanabból az általános szerződési feltételből négy verzió van a megosztott meghajtón, és senki sem jelölte meg, melyik hatályos. A tudásbázis-alapú asszisztens véletlenszerűen választ közülük.
- Örökölt jogosultságok hiánya. A dokumentumokat betöltik az AI-rendszerbe, de a mappaszintű hozzáférési jogokat nem viszik át. Így a gyakornok is megkapja a bérszámfejtési táblázat tartalmát, ha jól kérdez.
- Hiányos törzsadatok. Az ERP-ben a cikkek harmadánál nincs kitöltve a kategória vagy a mértékegység, ezért az ajánlatkészítő automatizmus rossz árat számol.
- Ismeretlen eredetű adatok. Senki sem tudja megmondani, milyen jogalapon és milyen tájékoztatással kerültek egy Excel-táblába az ügyféladatok, ezért később nem lehet igazolni, hogy az AI-felhasználás jogszerű.
Ezek közül egyik sem modellprobléma, és egyiket sem oldja meg egy drágább AI-eszköz. Az adatok szerkezetéről, tárolásáról és összekapcsolásáról részletesen írtunk az AI-hoz szükséges adatarchitektúráról szóló cikkünkben.
Az adatminőség szempontjai AI-projektekben
Az AI-adatminőséget nem lehet egyetlen számmal leírni. Az OECD útmutatója nyolc szempontot emel ki, és külön ellenőrzést javasol a hiányzó, elavult, kiugró vagy inkonzisztens értékekre, valamint az időbélyegekre és a késleltetésre. A táblázatban azt mutatjuk meg, hogyan fordíthatók le ezek egy középvállalat kérdéseire.
| Szempont | Mit kérdez | Példa egy középvállalatnál |
|---|---|---|
| Pontosság | Megfelel-e az adat a valóságnak? | Egyeznek-e az ERP készletadatai a raktári leltárral? |
| Robusztusság | Kibírja-e a rendszer a zajos, hibás bemenetet? | Elboldogul-e a számlafeldolgozó a gyűrött, ferdén szkennelt számlákkal? |
| Célnak való megfelelés | Az adott feladatra alkalmas-e az adat? | Lehet-e a webshop rendeléseiből nagykereskedelmi keresletet előre jelezni? |
| Specifikusság | Elég részletes-e? | Termékszintű vagy csak kategóriaszintű az értékesítési adat? |
| Reprezentativitás | Lefedi-e a valós eseteket? | Csak a budapesti ügyfelek reklamációi vannak meg, a vidékieké nem? |
| Befogadás | Kimarad-e egy csoport? | Hiányoznak-e a részmunkaidős dolgozók egy HR-elemzésből? |
| Sokféleség | Elég változatos-e az adat? | Csak egy beszállító dokumentumformátumán tanult a kinyerő modell? |
| Nyomonkövethetőség | Visszavezethető-e a forrásig? | Kiderül-e, melyik dokumentumból idézett az asszisztens? |
A gyakorlatban először azt az egy-két szempontot érdemes mérni, amelyik az adott felhasználási esetnél a legtöbbet számít. Egy szerződéselemző asszisztensnél a nyomonkövethetőség és a naprakészség az első. Egy előrejelző modellnél a reprezentativitás és a pontosság.
Szabályok: GDPR, AI Act és a magyar végrehajtás
GDPR: ami már ma kötelező
Ha az AI-rendszer személyes adatot kezel, a GDPR teljes egészében vonatkozik rá, függetlenül attól, hogy nagy kockázatúnak minősül-e. A Nemzeti Adatvédelmi és Információszabadság Hatóság (NAIH) a magyarországi bankok MI-rendszereiről szóló jelentésében kimondja, hogy az MI tudását elsősorban a tanításra használt adatok határozzák meg. Ezért vizsgálni kell az adatok minőségét, szükségességét, forrását és személyhez köthetőségét. A jelentés ezek mellett elvárja:
- személyes adat csak megfelelő jogalappal használható, és az érintetteket tájékoztatni kell;
- ahol lehet, anonim adatot kell alkalmazni;
- érvényesíteni kell az adatminimalizálás elvét és a megfelelő megőrzési időt;
- a tanítóadatok forrását dokumentálni kell.
A tét valós. A NAIH 2022-ben 250 millió forint bírságot szabott ki egy magyarországi bankra, mert mesterséges intelligenciát alkalmazó adatkezelési gyakorlata nem volt összhangban a GDPR-ral.
Sok vállalat a jogos érdekre hivatkozva használna ügyféladatot AI-hoz. Az Európai Adatvédelmi Testület 28/2024. számú véleménye szerint ehhez három dolgot kell igazolni: az érdek azonosítását, az adatkezelés szükségességét és az érdekek mérlegelését. Az ügyféltörzs gyakran a legérzékenyebb pont, mert évek alatt, különböző jogalapokon gyűlt össze. Az ügyféltörzsadatok GDPR-szabályai jó kiindulópontot adnak a rendrakáshoz, mielőtt ezek az adatok bármilyen AI-folyamatba bekerülnének.
A webes adatgyűjtés külön kérdés. Az EDPB 2026-ban új iránymutatást fogadott el a generatív AI-hoz kapcsolódó web scrapingről és az anonimizálásról, és ebben a megfelelő jogalap szükségességét hangsúlyozza. Ha cége nyilvános weboldalakról gyűjtene adatot egy modellhez, a jogalapot még a gyűjtés előtt egyeztesse az adatvédelmi tisztviselőjével vagy adatvédelmi ügyvéddel, ne utólag.
EU AI Act: adatkormányzás nagy kockázatú rendszereknél
Az (EU) 2024/1689 rendelet 10. cikke adatkormányzási és adatminőségi követelményeket ír elő a nagy kockázatú MI-rendszerek tanító-, validálási és tesztadatkészleteire. Ezeknek relevánsnak, kellően reprezentatívnak, a rendeltetés szempontjából a lehető legnagyobb mértékben hibától mentesnek és teljesnek kell lenniük. Vizsgálni kell azokat a torzításokat, amelyek hatással lehetnek az egészségre, a biztonságra vagy az alapvető jogokra, és azonosítani és kezelni kell az adathiányokat.
A nagy kockázatú kategóriába tartozik például a toborzásban és a munkavállalók értékelésében használt AI. Ezekre a rendszerekre vonatkozó kötelezettségek alkalmazását az uniós Digital Omnibus csomag későbbre tolta. A halasztás azonban felkészülési időt ad, nem felmentést: a 10. cikk szerinti adatdokumentációt nem lehet az utolsó hónapban utólag összerakni. Ha önéletrajzokat vagy jelölti válaszokat dolgozna fel AI-val, érdemes áttekinteni a toborzási AI adatvédelmi szempontjait, mert ezen a területen a GDPR és az AI Act követelményei egyszerre érvényesek.
A magyar végrehajtás és a nemzeti stratégia
Az AI Act hazai végrehajtásáról a 2025. évi LXXV. törvény rendelkezik, amely felhatalmazza a Kormányt az MI bejelentő hatóság és az MI piacfelügyeleti hatóság rendeleti kijelölésére. Magyarország Mesterséges Intelligencia Stratégiája a felelős MI-használathoz adatbiztonságot, adatminimalizálást, anonimizálást, auditálást, átláthatóságot, egyértelmű felelősséget és emberi felügyeletet kapcsol. Az üzleti döntéshozatalban a kötelező dokumentáció mellett megmagyarázható AI (XAI) technikák alkalmazását is ajánlja. Ez a lista vállalati szinten egyben jó ellenőrzőlista is.
Ki felel az adatokért középvállalati méretben
A nagyvállalati útmutatók adatért felelős igazgatóról (CDO), információbiztonsági vezetőről (CISO) és adatvédelmi vezetőről beszélnek. Egy 100–500 fős cégnél ezek a pozíciók ritkán léteznek külön, a feladatok viszont igen. A megoldás nem új státuszok létrehozása, hanem a meglévő szerepek egyértelmű kijelölése.
| Szerep | Ki tölti be jellemzően | Feladata az AI-adatirányításban |
|---|---|---|
| Adatgazda | Az adatkör üzleti vezetője, például értékesítési vagy pénzügyi vezető | Dönt arról, mire használható az adat, és felel a minőségéért |
| Műszaki felelős | IT-vezető vagy rendszergazda | Hozzáférések, integráció, naplózás, mentés |
| Információbiztonsági felelős | IT-biztonsági szakember vagy külső szolgáltató | Adatosztályozás, kockázatelemzés, incidenskezelés |
| Adatvédelmi tisztviselő | Belső DPO vagy megbízott jogász | Jogalap, tájékoztatás, hatásvizsgálat, megőrzési idők |
| AI-projektfelelős | A felhasználási eset üzleti tulajdonosa | Összehangolja a fentieket, és felel az eredményért |
| Vezetői jóváhagyó | Ügyvezető vagy igazgatóság | Elfogadja a kockázati határt és a költségkeretet |
A legfontosabb szabály: minden AI-felhasználási esetnek legyen egy megnevezett tulajdonosa, és minden bevont adatkörnek egy megnevezett gazdája. Ha egy kérdésre („szabad-e ezt az ügyféladatot az asszisztensbe tölteni?”) senki sem tud egy héten belül felelősen igent vagy nemet mondani, az adatirányítás még nem működik.
Az adatirányítás bevezetése hat lépésben
- Indulás egy konkrét felhasználási esetből. Ne a teljes adatvagyon rendbetételével kezdjen. Válasszon egy üzleti problémát, például az ajánlatkészítés gyorsítását vagy a beérkező számlák feldolgozását, és határozza meg, pontosan milyen adatok kellenek hozzá. Az OECD útmutatója is ezzel indít: azonosítani a projekthez szükséges adatokat, felmérni a meglévők minőségét és az adatfelvételi hiányokat.
- Adatleltár és osztályozás. Rögzítse, hol van az adat, ki a gazdája, milyen érzékenységű (nyilvános, belső, bizalmas, személyes, különleges), és milyen jogalapon gyűlt össze. A címkék később a technikai kontrollok alapjai lesznek.
- Minőségmérés és hiánypótlás. A fenti táblázat releváns szempontjai szerint mintavételezze az adatokat. Pótolja a hiányokat, tisztítsa és címkézze az adatokat, és jelölje ki, ki felel a folyamatos karbantartásért.
- Jogalap és kockázatértékelés. Az adatvédelmi tisztviselővel ellenőrizze a jogalapot és a tájékoztatást. Ahol a kockázat magas, készüljön adatvédelmi hatásvizsgálat. Döntse el azt is, hogy az AI Act szerint a felhasználás nagy kockázatú-e. Határozza meg és a vezetéssel fogadtassa el a kockázati határt.
- Technikai kontrollok. A szabályokat a rendszernek kell kikényszerítenie, nem a felhasználók jóindulatának. A gyakorlatban ez a következőket jelenti: a dokumentumok hozzáférési jogai öröklődjenek a tudásbázisba, a személyes adatok maszkolva vagy álnevesítve jussanak a modellhez, a naplók megőrzési ideje legyen beállítva, és az érzékeny kimenetek emberi jóváhagyás után kerüljenek ki. Erről bővebben az adatbiztonságról AI-projektekben szóló útmutatónkban írtunk.
- Dokumentáció és felülvizsgálat. Írja le, mi történt az első öt lépésben, és ütemezze be a felülvizsgálatot (lásd a következő részt).
A lépések egy kontrollált pilotban a legkönnyebben próbálhatók ki, ahol kevés adattal és szűk felhasználói körrel derül ki, hol vannak a hiányok. Ha az első kérdés az, hogy a cég adatai és szervezete egyáltalán készen áll-e, akkor AI-felkészültségi és governance-felmérésünk erre ad strukturált választ.
Dokumentáció és rendszeres felülvizsgálat
Az AI-rendszerek adatai nem maradnak változatlanok: új dokumentumok kerülnek a tudásbázisba, változnak az árlisták, a modellt frissíti a szolgáltató. A dokumentáció ezért élő anyag. A nemzeti MI-stratégia szerint az adatokat az adatvagyon-leltár alapján kell címkézni, a hozzáféréseket folyamatosan monitorozni és naplózni, az adatkezelést, megőrzést és törlést pedig dokumentált, rendszeresen felülvizsgált szabályzatban kell rögzíteni.
Egy működő dokumentációs csomag minimum ezeket tartalmazza:
- Adatlap felhasználási esetenként: milyen adatkörök, milyen forrásból, milyen jogalapon, ki a gazdájuk.
- Tanító- és tesztadatok leírása, ha a modellt saját adaton tanították. A NAIH jelentése egy képfeldolgozó modell kapcsán külön kiemeli, hogy a tanítóadatok forrását és körét, valamint a pontosság mérését dokumentálni kell.
- Pontossági és hibamérések: mennyi a téves válasz vagy hibás kinyerés aránya, és hogyan változik.
- Hozzáférési és használati naplók, beállított megőrzési idővel.
- Változásnapló: mikor cserélődött a modell, a promptok vagy az adatforrás.
A felülvizsgálat ritmusa a kockázathoz igazodjon. Egy belső tudásbázis-asszisztensnél jellemzően elég negyedévente átnézni a forrásokat és a jogosultságokat. Egy ügyfeleket vagy munkavállalókat érintő döntéstámogató rendszernél sűrűbben érdemes, és minden nagyobb változás után külön is.
A mi nézőpontunk
Az AI-adatirányítás nálunk nem a projekt végén kipipálandó megfelelőségi feladat, hanem az első workshopon kezdődik. Amikor egy cég AI-lehetőségeit felmérjük, minden ötletnél ugyanazt kérdezzük: melyik üzleti problémát oldja meg, mennyit hoz, és rendelkezésre áll-e hozzá jogszerűen használható, elég jó minőségű adat. Gyakran az utolsó kérdés dönti el a sorrendet. Egy közepes megtérülésű, de tiszta adatokra épülő felhasználási eset többet ér az első körben, mint egy látványos ötlet, amelyhez fél év adattisztítás kell.
Vendorfüggetlenül dolgozunk, ezért nem egy eszközből indulunk ki, hanem abból, milyen kontrollokra van szüksége az adott adatnak. A governance, az adatbiztonság, az emberi felügyelet és a visszakereshetőség nálunk a megoldás része, nem utólagos kiegészítés. Úgy látjuk, hogy a sikeres AI-bevezetés fokozatos: egy kontrollált pilot, mérhető eredmény, majd a tanulságok alapján a következő lépés. Az adatirányítás pedig pontosan az a fegyelem, amely ezt a fokozatosságot biztonságossá teszi.
— Zsolt
Hol érdemes elkezdeni
Ha szeretné egy napon belül látni, mely AI-lehetőségek reálisak a cégénél, és ezekhez milyen adatokat kell előbb rendbe tenni, az AI Discovery Workshop erre készült. A workshop ára 390 000 Ft, egyszeri díj. Az eredmény egy priorizált lista a felhasználási esetekről, megtérülési és adatfelkészültségi szempontból értékelve.
Ha már megvan a kiválasztott felhasználási eset, a kontrollált AI-bevezetés keretében lehetőségfelméréstől a pilotig visszük végig, az adatirányítási kontrollokkal együtt. A szabályzatok, kockázatkezelés és adatvédelmi megfelelés kérdéseiben AI compliance szolgáltatásunk nyújt támogatást.
Gyakori kérdések
Kell-e egy középvállalatnak külön adatirányítási csapat az AI-hoz?
Általában nem. A meglévő szerepeket kell egyértelműen kijelölni: adatgazdát, műszaki felelőst, információbiztonsági felelőst és adatvédelmi tisztviselőt. Ami hiányzik, az a koordináció, ezért minden AI-felhasználási esethez kell egy megnevezett üzleti tulajdonos.
Vonatkozik-e az AI Act a belső használatú AI-asszisztensünkre?
A rendelet a kockázati besorolástól függően eltérő kötelezettségeket ír elő. A 10. cikk szigorú adatkormányzási követelményei a nagy kockázatú rendszerekre vonatkoznak, egy belső tudásbázis-asszisztens jellemzően nem ilyen. A GDPR viszont minden személyes adatot kezelő AI-ra érvényes, a besorolást pedig érdemes jogásszal vagy adatvédelmi tisztviselővel együtt elvégezni.
Betölthetjük-e az ügyféladatokat egy AI-eszközbe?
Csak akkor, ha van rá érvényes jogalap, az ügyfelek tájékoztatása lefedi ezt a felhasználást, és csak a feladathoz szükséges adatkör kerül be. Ahol lehet, álnevesített vagy anonim adatot használjon. Azt is ellenőrizze, hogy az eszköz szolgáltatója hol tárolja az adatot, és felhasználja-e a saját modelljei tanításához.
Mennyi idő alatt vezethető be az AI-adatirányítás?
Egy konkrét felhasználási esetre szűkítve az adatleltár, a minőségmérés és az alapkontrollok jellemzően néhány hét alatt elkészülnek. A teljes vállalati adatvagyon rendezése hosszabb folyamat. Ezért javasoljuk, hogy esetről esetre, a pilotokkal párhuzamosan épüljön fel.
Források
- Fintech.hu: A rossz adatokon bukhatnak el a vállalati AI-projektek
- OECD: Assessing readiness for AI
- NAIH: Jelentés a magyarországi bankok MI-rendszereinek adatkezeléséről
- NAIH: Adatvédelem Napja 2026
- EDPB: 28/2024. sz. vélemény az MI-modellekről
- NAIH: Az EDPB iránymutatásai az anonimizálásról és a webes adatgyűjtésről
- EU AI Act, 10. cikk: Adatok és adatkormányzás
- Jogi Fórum: Digital Omnibus, halasztás az AI Act magas kockázatú szabályaiban
- 2025. évi LXXV. törvény az uniós MI-rendelet magyarországi végrehajtásáról
- Magyarország Mesterséges Intelligencia Stratégiája