
A RAG-rendszer indexét nem egy általános ütem szerint érdemes frissíteni. Az számít, hogy mennyibe kerül Önnek egy elavult válasz. Az árlistát, a készletadatot vagy a hatályos belső szabályzatot olvasó asszisztensnél percek vagy órák a megengedhető késés. Egy archív projektdokumentációnál a napi vagy heti frissítés is bőven elég. A jó gyakorlat ezért nem egyetlen ütemet ír elő: adatforrásonként külön határozza meg a frissítést, a változásokat inkrementálisan dolgozza fel, a törléseket külön kezeli, és időnként teljesen újraépíti az indexet. Az alábbiakban végigvesszük, hogyan dönthet el mindezt a saját rendszerére, és milyen mutatókkal ellenőrizheti, hogy jó-e a választott ütem.
Röviden
- A frissítési gyakoriságot az határozza meg, mekkora késést bír el az üzlet, és mibe kerül egy elavult információból adott válasz, nem egy kerek szám.
- Adatforrásonként érdemes külön ütemet adni: a gyorsan változó adat eseményvezérelt frissítést kap, a stabil tartalom ütemezett kötegelt frissítést.
- Napi működésben az inkrementális frissítés a hatékony út, amely csak az új és módosult dokumentumokat dolgozza fel. Teljes újraindexelésre szerkezeti változásnál és időszakos tisztításnál van szükség.
- A törlés külön feladat. Ha elmarad, a rendszer olyan tartalomból is válaszolhat, amelynek már nem szabadna léteznie, és ez adatvédelmi kockázat is.
- Az ütemet mérni kell: az indexelési késés, a törlések átfutási ideje és az elavult válaszok aránya mutatja meg, hogy jól döntött-e.
Tartalomjegyzék
- Miért nincs egyetlen helyes frissítési ütem
- A frissítési ütem három meghatározója
- Ütemezett, eseményvezérelt vagy közel valós idejű frissítés
- Teljes újraindexelés vagy inkrementális frissítés
- A törlés: a leggyakrabban elfelejtett frissítés
- Mikor kell teljesen újraépíteni az indexet
- Honnan tudja, hogy jó-e a frissítési ütem
- Szakmai nézőpontunk
- Ha most tervezi a RAG-rendszerét
- Gyakran ismételt kérdések
- Források
Miért nincs egyetlen helyes frissítési ütem
A RAG-ra épülő asszisztens (Retrieval-Augmented Generation, vagyis visszakereséssel kiegészített szöveggenerálás) nem a nyelvi modell „emlékezetéből” válaszol. Minden kérdésnél a saját indexéből keresi elő a releváns szövegrészeket. Ebből következik, hogy a válasz legfeljebb annyira lehet friss, amennyire az index az. Ha a beszerzési szabályzat múlt héten megváltozott, de az index még a régi változatot tartalmazza, az asszisztens magabiztosan a régit fogja idézni.
A frissítés ugyanakkor nem ingyenes. Minden feldolgozott dokumentumot fel kell darabolni, a darabokból embeddinget (vektoros reprezentációt) kell számolni, majd be kell írni őket a vektoradatbázisba. Ez számítási kapacitást, API-hívásokat és üzemeltetési figyelmet igényel. Az indexet tehát nem kell feltétlenül „mindig a lehető legfrissebben” tartani. Olyan ütemet kell találni, ahol a késés okozta üzleti kár és a frissítés költsége egyensúlyban van.
A RAG-tudásbázisok karbantartásával foglalkozó tananyag is három tényezőből vezeti le a gyakoriságot: milyen gyorsan változik az adatforrás, mekkora adatkésést bírnak el az üzleti döntések, és mekkora a költségkeret. A gyakorlatban ezt úgy fordítjuk le, hogy minden adatforrásnál feltesszük a kérdést: ha ez a dokumentum ma megváltozik, és az asszisztens holnapig a régi változatot mondja, mi történik? Ha a válasz az, hogy „semmi különös”, a napi frissítés elég. Ha az, hogy „rossz árat adunk az ügyfélnek”, akkor órákban vagy percekben kell gondolkodni.
A frissítési ütem három meghatározója
Az adatforrás változékonysága
Egy vállalati tudásbázis ritkán egységes. Ugyanabban a rendszerben lehet egy ritkán módosított termékkézikönyv, egy hetente frissülő árlista és egy naponta bővülő ügyféljegy-adatbázis. Ha mindegyiket ugyanarra az ütemre állítja, vagy feleslegesen dolgozza fel újra a stabil tartalmat, vagy túl lassan követi a gyorsan változót.
Az elviselhető késés
Ez üzleti kérdés, nem technikai. Az ügyfélszolgálati asszisztensnél a téves szállítási határidő panaszt szül, a belső HR-asszisztensnél egy elavult szabadságolási szabály félreértést. A tudásalapú ügyfélszolgálati asszisztensek kockázatairól külön cikkben írtunk részletesen.
A költségkeret
Minél sűrűbb a frissítés és minél nagyobb a korpusz, annál többe kerül a feldolgozás. Ezért fontos, hogy a frissítés csak azt dolgozza fel, ami valóban változott.
Az alábbi táblázat kiindulópontként szolgál. Projektjeinkben ebből indulunk, majd az adott cég adataira és kockázataira szabjuk:
| Adatforrás típusa | Jellemző változás | Javasolt kiinduló ütem | Frissítés módja |
|---|---|---|---|
| Árlista, készlet, akciók | naponta többször | percek vagy órák | eseményvezérelt, inkrementális |
| Ügyféljegyek, e-mailek, CRM-jegyzetek | folyamatosan | óránként vagy közel valós időben | eseményvezérelt, inkrementális |
| Belső szabályzatok, eljárásrendek | havonta, negyedévente | naponta, éjszakai kötegben | ütemezett, inkrementális |
| Termékkézikönyvek, műszaki leírások | verzióváltáskor | naponta vagy kiadáskor | ütemezett vagy kiadáshoz kötött |
| Archív projektanyagok | szinte soha | hetente vagy havonta | ütemezett köteg |
| Bármely forrás, ha törölni kell | eseti | azonnal | külön törlési folyamat |
A táblázat utolsó sora szándékosan lóg ki a többi közül. A törlésről alább külön is szó lesz.
Ütemezett, eseményvezérelt vagy közel valós idejű frissítés
Három alapmintából lehet választani, és egy érett rendszerben általában mindhárom megjelenik, más-más adatforrásnál.
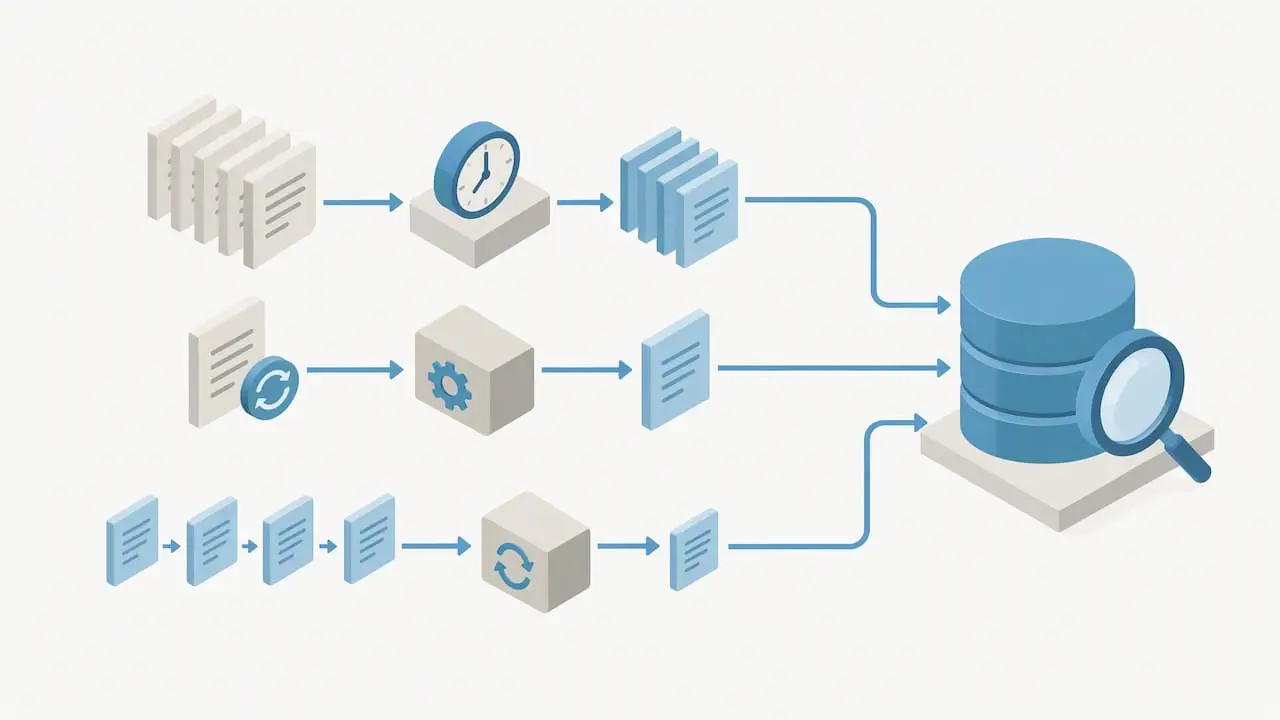
Ütemezett kötegelt frissítés. Egy időzített feladat, jellemzően éjszaka, végignézi a forrásokat, és feldolgozza a változásokat. Kiszámítható, könnyű felügyelni, és a terhelés is olyan időszakra esik, amikor senki sem dolgozik a rendszerrel. Hátránya, hogy a nap közben bekövetkezett változás csak másnap jelenik meg a válaszokban.
Eseményvezérelt frissítés. A forrásrendszer (dokumentumtár, CRM, ERP) jelez, amikor egy elem létrejön, módosul vagy törlődik, és a feldolgozó lánc csak azt az elemet indexeli újra. A tudásbázis-frissítési minták összevetése szerint az ütemezett megoldás egyszerűbben kezelhető, az eseményvezérelt pedig időérzékeny adatoknál reagál jobban. Az utóbbi évek iránya egyértelműen ez: az éjszakai teljes újraépítés helyett eseményekre reagáló, inkrementális indexelés.
Közel valós idejű keresés. Itt a változás másodperceken belül kereshetővé válik. Érdemes tudni, hogy a keresőmotorok sem feltétlenül azonnal mutatják az új adatot. Az Elasticsearch például alapértelmezés szerint másodpercenként frissít, de csak azokat az indexeket, amelyekre az elmúlt 30 másodpercben keresés érkezett. A frissítés időköze állítható, és API-hívással is kikényszeríthető. Ha a csapata ilyen motorra épít, a tényleges késés tehát a feldolgozó lánc és a motor beállításainak együttesén múlik.
Az eseményvezérelt láncnál van egy mérnöki feltétel, amelyet nem lehet megkerülni: a feldolgozásnak idempotensnek kell lennie. Ugyanaz az esemény kétszer is megérkezhet, és a módosítások sorrendje is felcserélődhet egy üzenetsorban. Verziószámok vagy időbélyegek nélkül könnyen előfordul, hogy egy régebbi változat felülírja az újabbat.
Teljes újraindexelés vagy inkrementális frissítés
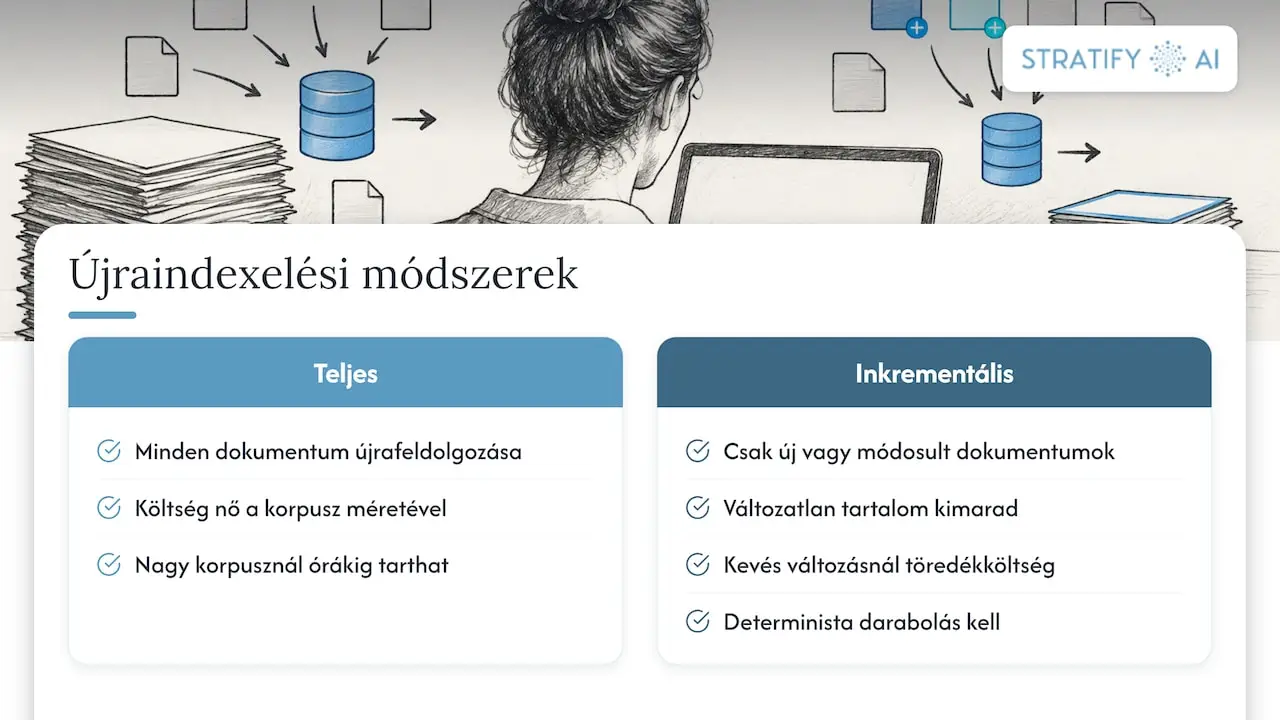
Teljes újraindexeléskor minden dokumentumot újra feldolgoz a rendszer: darabol, embeddinget számol és beír. Ez egyszerű és tiszta eljárás, de a költsége a korpusz méretével arányosan nő. Néhány száz dokumentumnál ez nem gond. Több tízezer szerződés, e-mail vagy műszaki rajzleírás esetén viszont már órákat és komoly összeget jelenthet minden futás.
Inkrementális frissítéskor a rendszer minden dokumentumhoz eltárol egy tartalmi ujjlenyomatot (hash-t), és a következő futáskor csak azokat dolgozza fel, amelyeknek az ujjlenyomata megváltozott, vagy amelyek újak. Ha a tudásbázisnak naponta csak kis hányada változik, ez a futásidőt és a költséget is töredékére csökkenti, hiszen a változatlan tartalomhoz hozzá sem kell nyúlni.
Az inkrementális megközelítésnek is van finomhangolási kérdése: dokumentum vagy darab (chunk) szinten figyeli-e a változást. Ha egy százoldalas kézikönyvben egyetlen bekezdés módosul, a darabszintű összehasonlítás csak azt az egy darabot számolja újra. Ehhez viszont a darabolásnak determinisztikusnak kell lennie, vagyis ugyanabból a szövegből mindig ugyanazokat a darabokat kell előállítania. A darabolás és a visszakeresés minőségének összefüggéséről a fejlett vektorkeresésről szóló írásunkban olvashat bővebben.
A törlés: a leggyakrabban elfelejtett frissítés
A legtöbb indexelő lánc jól kezeli az új és a módosult dokumentumokat, a törölteket viszont elfelejti. Ha egy fájlt kitörölnek a dokumentumtárból, a hash-alapú összehasonlítás nem talál hozzá új változatot, ezért nem is nyúl hozzá, a régi darabok pedig ott maradnak a vektoradatbázisban. Az asszisztens így hónapokkal később is idézhet egy visszavont árajánlatból vagy egy megszüntetett szabályzatból.
Ezért a törlést külön folyamatként érdemes megtervezni. A forrásrendszer törlési eseményt küld, vagy egy úgynevezett tombstone jelölést hagy hátra, amelyet a feldolgozó lánc kifejezetten keres, és az alapján eltávolítja az összes kapcsolódó darabot. Ahol ilyen esemény nem érhető el, ott időszakos egyeztetés kell: a lánc összeveti a forrás aktuális dokumentumlistáját az index tartalmával, és ami a forrásban már nincs meg, azt törli.
Személyes adatoknál ez adatvédelmi kötelezettség is. Ha egy ügyfél élt az elfeledtetéshez való jogával, az adatait nemcsak a CRM-ből, hanem minden olyan indexből is el kell távolítani, amelyből egy AI-asszisztens előkeresheti őket. Ez az egyik oka, hogy a törlési ütemet adatforrástól függetlenül „azonnalinak” jelöltük a táblázatban. Ha bizonytalan abban, hogy a saját RAG-láncára milyen adatvédelmi kötelezettségek vonatkoznak, kérje ki az adatvédelmi tisztviselője vagy adatvédelemre szakosodott jogász véleményét, mielőtt személyes adatot tartalmazó forrást kapcsol be. Az AI compliance szolgáltatásunk éppen ezeket a szabályzatokat és kockázatkezelési lépéseket fogja össze.
Mikor kell teljesen újraépíteni az indexet
Az inkrementális frissítés a napi működés eszköze, de vannak helyzetek, amikor nem lehet megúszni a teljes újraépítést. A tudásbázis-karbantartási útmutató kisebb tudásbázisoknál, ritka nagy átalakításoknál és időszakos mélytisztításként tartja indokoltnak. Mi az alábbi esetekben javasoljuk:
- Embeddingmodell-csere. Az új modell vektorai nem hasonlíthatók össze a régiekkel, ezért a teljes korpuszt újra kell számolni. Ez valójában migráció, nem frissítés. Biztonságosan úgy végezhető el, hogy egy párhuzamos (shadow) indexet építünk, teszt-kérdéssoron összevetjük a két index találatait, és csak ezután állunk át.
- Darabolási stratégia változása. Ha más méretű vagy más logikájú darabokra bontjuk a dokumentumokat, a régi és az új darabok nem keverhetők.
- Metaadat-séma bővítése. Ha például új jogosultsági vagy nyelvi címke kerül a darabokra, a régi tételekre is rá kell kerülnie, különben a szűrés hiányosan működik. Több nyelvű tudásbázisnál ez különösen gyakori, erről a többnyelvű RAG-ról szóló cikkünkben írtunk.
- Időszakos tisztítás. A gráfalapú közelítő keresőindexekben (például HNSW) a sok törlés és módosítás idővel ronthatja a keresés minőségét, mert a gráf szerkezete fokozatosan torzul. Ezért a gyakorlatban bevált a hibrid minta: napi inkrementális frissítés, mellette tervezett, ritkább teljes újraépítés vagy tömörítés.
Honnan tudja, hogy jó-e a frissítési ütem
A frissítési ütem nem beállítás, amelyről egyszer dönt, és utána elfelejti. Mérni kell, különben csak akkor derül ki a hiba, amikor egy ügyfél vagy kolléga szól. Ezeket a mutatókat és ellenőrzéseket építjük be a projektjeinkbe:
- Indexelési késés. Mennyi idő telik el aközött, hogy egy dokumentum megváltozik a forrásban, és hogy a módosított változat kereshetővé válik? Ezt adatforrásonként érdemes mérni, és összevetni az üzlettel egyeztetett célértékkel.
- A törlések átfutási ideje. Egy törölt dokumentum mennyi idő után tűnik el az indexből? Ez legyen külön mutató, mert a hibás törléskezelés máshol nem látszik.
- Forrás és index egyezése. Rendszeres összevetés: hány dokumentum van a forrásban, hány az indexben, és melyek hiányoznak vagy maradtak benn feleslegesen.
- Sikertelen feldolgozások. Hány dokumentumot nem sikerült beolvasni, és miért (sérült PDF, jogosultsági hiba, túl nagy fájl)? Egy csendben elakadt lánc rosszabb a lassúnál.
- Elavult válaszok aránya. Egy rögzített tesztkérdés-sor, amelynek egy része szándékosan friss változásokra kérdez rá. Ha az asszisztens a régi tartalmat adja vissza, az ütem vagy a lánc hibás.
- Felhasználói jelzések. A „ez már nem igaz” típusú visszajelzések címkézve, adatforráshoz kötve a legolcsóbb korai figyelmeztetést adják.
Sokat segít, ha az asszisztens minden válasz mellett feltünteti a felhasznált forrást és annak dátumát. A RAG-indexek frissességéről szóló összefoglaló is ezt javasolja: így a felhasználó maga is látja, ha egy válasz régi dokumentumra épül. Ez a bizalom szempontjából is számít. A chatbotok üzleti szerepéről szóló elemzések is azt mutatják, hogy egy asszisztens annyit ér, amennyire a felhasználói megbíznak a válaszaiban.
Szakmai nézőpontunk
Amikor egy cég RAG-rendszerének frissítési gondjaival keres meg minket, ritkán az indexelő technológia a valódi ok. Sokkal gyakoribb, hogy senki sem döntötte el, melyik adatforrás mennyire üzletkritikus, és ki felel azért, hogy a forrás naprakész legyen.
Ezért mi sem eszközzel kezdünk, hanem az üzleti céllal és a kockázattal. Adatforrásonként meghatározzuk, mekkora késés fogadható el, mibe kerül egy elavult válasz, és ki a tartalom gazdája. Ebből vezetjük le az ütemezést, a törléskezelést és a mérőszámokat. A frissítési láncot vendorfüggetlenül tervezzük, így az a meglévő dokumentumtárhoz és vállalatirányítási rendszerhez illeszkedik, nem fordítva.
A governance-t, a naplózást és az emberi felügyeletet nem utólag tesszük rá a rendszerre. Már az első pilotban benne vannak, mert egy tudásalapú asszisztens csak akkor hoz mérhető értéket, ha a felhasználók megbíznak benne. Ez a bizalom pedig azon múlik, hogy az index azt tükrözi-e, ami ma igaz a cégnél.
Zsolt
Ha most tervezi a RAG-rendszerét
Az indexelési ütem azoknak a döntéseknek az egyike, amelyeket a legjobb már a tervezéskor meghozni, nem az első panasz után. Az AI Discovery Workshop keretében, 390 000 Ft egyszeri díjért, együtt térképezzük fel, mely üzleti folyamataiban és adatforrásaiban hoz valódi értéket egy tudásalapú asszisztens, és milyen adatminőségi és frissítési követelményekkel kell számolni.

Ha már megvan az irány, a kontrollált AI-bevezetés során pilotban építjük fel a frissítési láncot a mérőszámokkal és a törléskezeléssel együtt, mielőtt a rendszer a teljes szervezet elé kerül. A RAG vállalati bevezetésének üzleti oldaláról ebben az összefoglalónkban olvashat bővebben.
Gyakran ismételt kérdések
Elég, ha a RAG-indexet naponta egyszer, éjszaka frissítjük?
Stabil tartalomnál, például szabályzatoknál, kézikönyveknél vagy archív anyagoknál általában igen. Gyorsan változó adatnál, például árlistánál, készletnél vagy ügyféljegyeknél a napi köteg túl lassú lehet, ott eseményvezérelt frissítést érdemes használni. A törléseket a napi ütemtől függetlenül, a lehető leggyorsabban kell feldolgozni.
Mennyibe kerül a gyakoribb indexelés?
Teljes újraindexelésnél a költség a korpusz méretével nő, ezért ott a sűrűbb frissítés gyorsan drágul. Inkrementális frissítésnél csak a változott tartalmat dolgozza fel a rendszer, így a költség a változás mértékéhez igazodik, nem a tudásbázis teljes méretéhez. A pontos összeg a dokumentumok mennyiségétől, az embeddingmodelltől és az infrastruktúrától függ.
Kell-e újraindexelni, ha lecseréljük a nyelvi modellt?
Ha csak a választ megfogalmazó nyelvi modellt cseréli, az indexhez nem kell hozzányúlni. Ha viszont az embeddingmodell változik, a teljes korpuszt újra kell számolni, mert a régi és az új vektorok nem hasonlíthatók össze. Ezt párhuzamos indexszel és tesztelés után érdemes élesíteni.
Hogyan derül ki, hogy a chatbot elavult tartalomból válaszol?
A legmegbízhatóbb jelzés egy rendszeresen futtatott tesztkérdés-sor, amely friss változásokra kérdez rá, kiegészítve a forrás és az index tartalmának összevetésével. Ha a válaszok mellett a forrásdokumentum dátuma is megjelenik, a felhasználók maguk is észreveszik, ha valami régi. A felhasználói visszajelzéseket adatforráshoz kötve érdemes gyűjteni.
Források
- Elasticsearch: Near real-time search (8.19)
- RAG Knowledge Base Management: Updates & Refresh
- RAG Index Freshness: Updates, Deletes and Re-indexing
- Rätt att bli glömd: så begär du radering enligt GDPR
- The Role of Chatbots in Business Success Today