
A személyes adatokat az AI két módszer együttes használatával ismeri fel jól. Szabályok és minták fogják meg a kötött formátumú azonosítókat, például az e-mail-címet, a telefonszámot és a bankszámlaszámot. Nyelvi modellek, úgynevezett névelem-felismerők (NER) találják meg a szabad szövegben a neveket, címeket és szervezeteket. A felismert adatot ezután maszkolni, álnevesíteni vagy anonimizálni kell, mielőtt egy AI-modellhez, keresőindexbe vagy naplóba kerül. Hogy melyik módszer kell, azt a cél és a jogi helyzet dönti el. A GDPR szerint ugyanis csak a valóban anonim adat kerül ki a rendelet hatálya alól, az álnevesített nem. Az alábbiakban végigmegyünk a felismerés technikáján, a három védelmi szint közötti különbségen, a magyar és uniós elvárásokon, valamint azon, hogyan ellenőrizheted, hogy a védelem tényleg működik.
Röviden
- A felismerés több rétegből áll: a mintaalapú szabályok a strukturált azonosítókat fogják meg, a NER-modellek a szabad szövegben szereplő neveket és címeket, a képekhez és hanganyagokhoz pedig külön eszközök kellenek.
- A maszkolás, az álnevesítés és az anonimizálás nem ugyanaz: az álnevesített adat továbbra is személyes adat, csak az anonim adatra nem vonatkozik a GDPR.
- A védelmet négy ponton kell beépíteni: a dokumentumok betöltésekor, a felhasználói promptnál, a modell válaszánál és a naplózásnál.
- A NAIH azt javasolja, hogy a modellek betanítása lehetőleg anonim adatokkal történjen, és hogy a jogalapot és az adatforrást dokumentáld.
- A hatékonyságot mérni kell: egy kézzel ellenőrzött mintán, újraazonosítási teszttel, és mindezt írásban rögzítve.
Tartalomjegyzék
- Mi számít személyes adatnak egy AI-projektben
- Hogyan ismeri fel az AI a személyes adatokat
- Maszkolás, álnevesítés, anonimizálás: mi a különbség
- Hol fut a felismerés egy AI-rendszerben
- Mit vár el a GDPR és a NAIH
- Hogyan ellenőrizd, hogy a védelem működik
- Technikai és szervezési intézkedések, amelyek csökkentik a kitettséget
- A mi nézőpontunk
- Így segítünk a bevezetésben
- Gyakori kérdések
- Források
Mi számít személyes adatnak egy AI-projektben
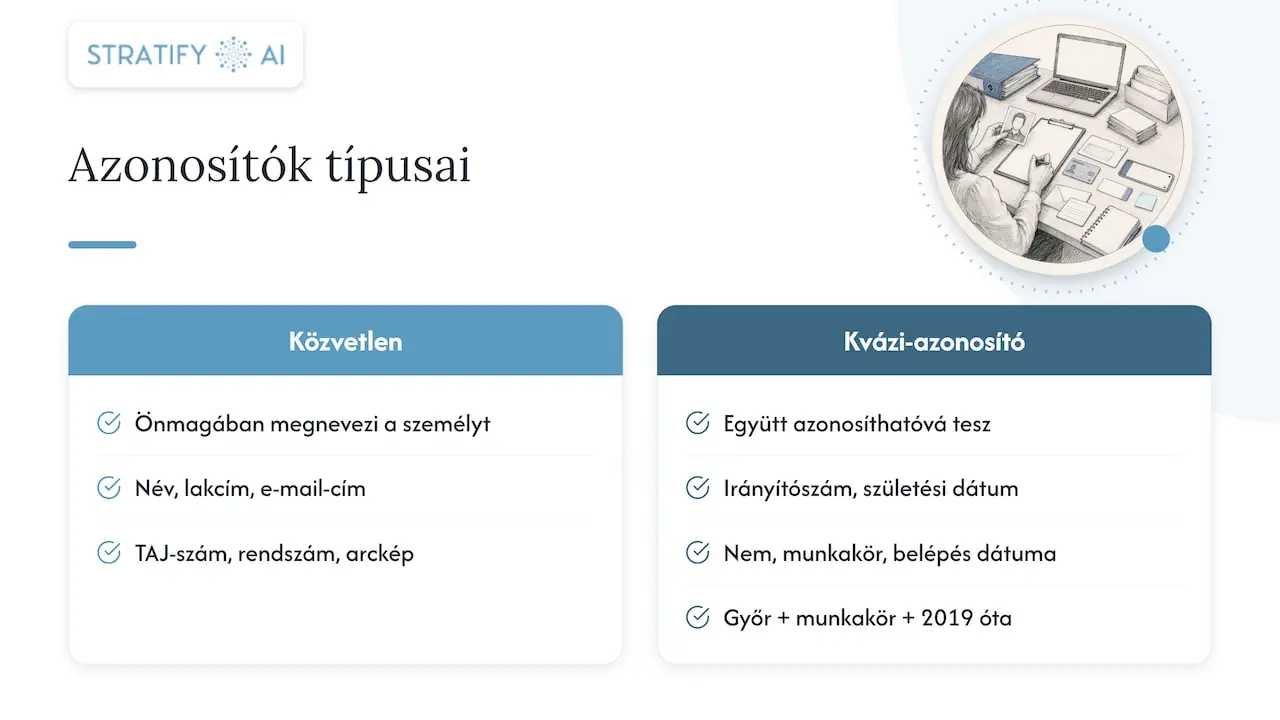
Az AI-projektekben kétféle adatra kell figyelni. A közvetlen azonosítók önmagukban megnevezik a személyt: név, lakcím, e-mail-cím, telefonszám, adóazonosító jel, TAJ-szám, személyi igazolvány száma, bankszámlaszám, rendszám, arckép, hangfelvétel. A kvázi-azonosítók egyenként ártalmatlannak tűnnek, együtt viszont kiszűrhetővé teszik a személyt. Ilyen például az irányítószám, a születési dátum, a nem, a munkakör és a belépés dátuma. Egy húszfős vidéki telephelyen a „logisztikai vezető, 2019 óta, Győr” leírás név nélkül is egyértelműen azonosít valakit.
Ez azért fontos, mert egy AI-rendszerbe ritkán érkeznek tiszta táblázatok. Ügyfélszolgálati e-mailek, szerződések, hibajegyek, értekezletek jegyzetei, beszkennelt számlák és hangfelvételek kerülnek be, és ezekben a személyes adat szövegkörnyezetbe ágyazva jelenik meg. Az EU adat-előkészítési útmutatója szerint ezért az AI-rendszerek adat-előkészítésekor bevett lépés az adatszanitizálás: a közvetlen és a kvázi-azonosítók eltávolítása vagy átalakítása.
Hogyan ismeri fel az AI a személyes adatokat
A jól működő felismerés nem egyetlen modellen alapul, hanem egymást kiegészítő rétegeken. Mindegyik másféle hibát fog meg.
Szabályok és minták
A kötött formátumú adatokra (e-mail-cím, IBAN, telefonszám, magyar adóazonosítók, rendszám) reguláris kifejezések és ellenőrzőszám-vizsgálatok a legmegbízhatóbbak. Gyorsak, olcsók, és pontosan megmondható róluk, mit találnak meg. A gyengeségük az, hogy a formátumon kívül semmit sem látnak: egy elírt vagy szóközökkel tagolt számot könnyen kihagynak, a nevekkel pedig egyáltalán nem boldogulnak.
Névelem-felismerés a szabad szövegben
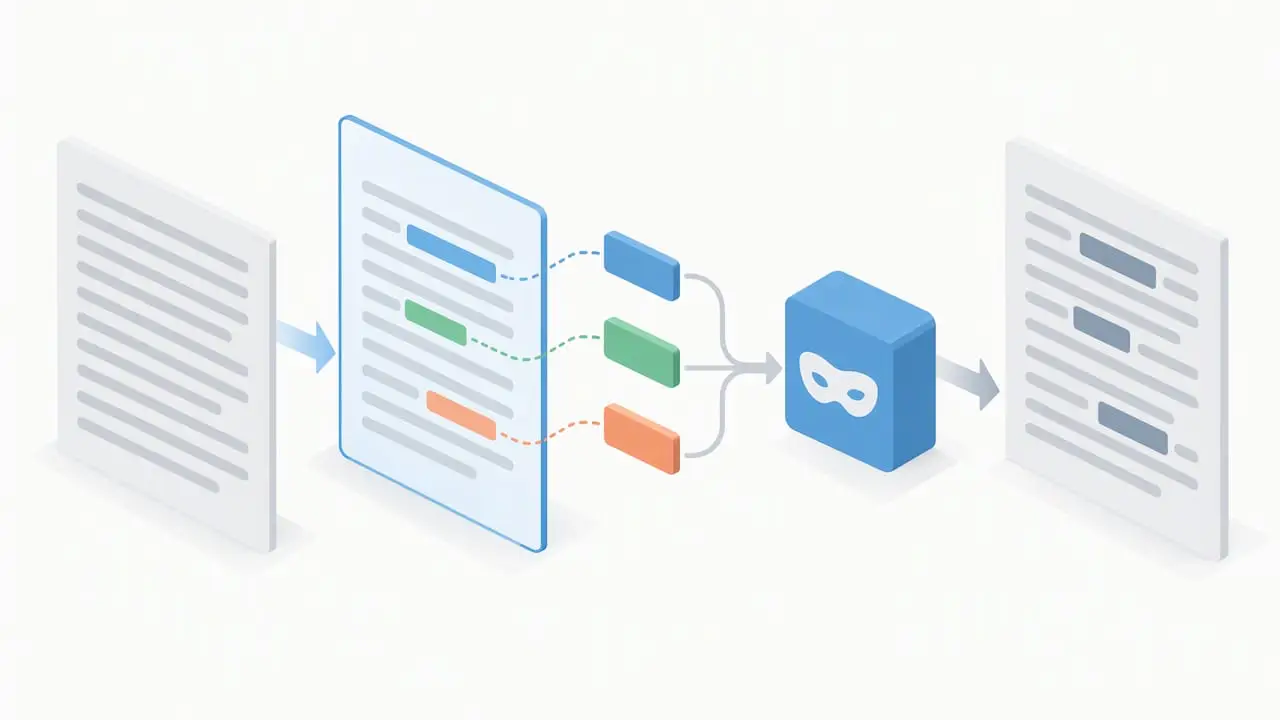
A nem strukturált adatoknál, vagyis szövegeknél a szingapúri kormányzati GovTech adatvédelmi gyakorlati útmutatója szerint a névelem-felismerés (Named Entity Recognition, NER) a bevett módszer: ezzel ismerik fel és takarják ki a személyes adatokat, mielőtt azok az AI-modellhez jutnának. A NER-modell a szövegkörnyezetből dönti el, hogy egy szó személynév, helynév vagy szervezet. Ugyanez a módszer a nagy nyelvi modellekkel is megoldható: a modellt arra utasítják, hogy jelölje meg a szövegben a személyes adatokat. Ez rugalmasabb megoldás, de drágább és lassabb, és a kimenetét is ellenőrizni kell.
Strukturált adatok: oszlopszintű felderítés
Adatbázisoknál és táblázatoknál először azt érdemes kideríteni, melyik oszlop tartalmaz személyes adatot. Az automatizált adatfeltárás az oszlopnevek, a mintaértékek és az értékeloszlás alapján jelöli meg a gyanús mezőket. Ezt egy adatgazda hagyja jóvá. Különösen veszélyesek a „megjegyzés” típusú szabad szöveges mezők, mert ezekbe a munkatársak bármit beírnak, a diagnózistól a magánszámig.
Képek, szkennelt dokumentumok és hang
A GovTech útmutató szerint kép- és hangadatoknál speciális gépi látási és akusztikai eszközökkel távolítják el az azonosító jegyeket, illetve torzítják a biometrikus információkat. A gyakorlatban ez a következőket jelenti: arcok és rendszámok kitakarása, szkennelt dokumentumok szövegfelismerése és utána a szöveges szűrés, hangfelvételeknél pedig átirat és hangtorzítás.
Miért nehezebb mindez magyarul
Az angol nyelvű eszközök a magyar szövegeken jellemzően rosszabbul teljesítenek. A ragozás miatt ugyanaz a név több alakban fordul elő: „Kovács Pétert”, „Kovácséknál”, „Péterrel”. Sok családnév köznév is (Fekete, Szabó, Kis, Takács), ezért a modell könnyen összetéveszti őket. A dátumok, címek és telefonszámok formátuma is eltér az angolszász mintáktól. Ezért mi minden projektben a cég saját, magyar nyelvű anyagain mérjük a felismerést, és nem a gyártói adatlapra hagyatkozunk.
Maszkolás, álnevesítés, anonimizálás: mi a különbség
A három fogalmat gyakran egymás szinonimájaként használják, pedig jogilag és technikailag mást jelentenek. Az EDPB anonimizálásról szóló oldala szerint az álnevesítés csökkenti, de nem szünteti meg az adat személyhez köthetőségét. Az anonimizálás ezzel szemben minden személytől elszakítja az adatot, így az kikerül a GDPR hatálya alól. Egy adat akkor anonim, ha észszerűen valószínűsíthető eszközökkel már nem kapcsolható az érintetthez.
| Szempont | Maszkolás | Álnevesítés | Anonimizálás |
|---|---|---|---|
| Mit csinál | Kitakarja vagy címkére cseréli az adatot, pl. [EMAIL] | Azonosítóra cseréli az adatot, a kulcsot külön tárolják | Visszafordíthatatlanul átalakítja vagy általánosítja az adatot |
| Visszafordítható? | Attól függ, megőrzik-e az eredetit | Igen, a kulcs birtokában | Nem |
| Személyes adat marad? | Ha visszafordítható, igen | Igen | Nem |
| Vonatkozik rá a GDPR? | Igen, ha az eredeti elérhető | Igen | Nem |
| Tipikus felhasználás | Promptok, válaszok, naplók, megjelenítés | Tanítóadat, elemzés, ahol később vissza kell keresni | Statisztika, modelltanítás, adatmegosztás |
A NAIH 2025-ös jelentése a banki AI-rendszerekről egy gyakori félreértést is tisztáz. Az anonimizálás és az álnevesítés jogilag meghatározott fogalom, a „személytelenítés” viszont nem. Ha egy szállító azt írja, hogy „személytelenített adatokkal dolgozik”, érdemes megkérdezni, hogy pontosan mit ért ezen.
Strukturált adatoknál a GovTech útmutató két megoldáscsoportot ír le. A maszkoláshoz tokenizálást vagy formátummegőrző titkosítást használnak, így például egy adóazonosító helyén továbbra is egy formailag érvényes, de hamis szám áll. Az anonimitás biztosítására általánosítással k-anonimitást, l-diverzitást vagy t-közelséget alkalmaznak. A születési dátumból így például születési évtized lesz, a pontos címből megye.
Hol fut a felismerés egy AI-rendszerben
A legtöbb adatvédelmi hiba nem a modellben keletkezik, hanem az adat útja mentén. Egy vállalati AI-asszisztensben vagy RAG-alapú tudásbázisban négy ponton kell szűrni:
- Betöltéskor: mielőtt a dokumentumok darabolva bekerülnek a keresőindexbe. Ami itt átcsúszik, az később bármelyik válaszban felbukkanhat.
- A felhasználói promptnál: a munkatársak bemásolnak ügyféllevelet, önéletrajzot vagy táblázatot. Ha a modell külső szolgáltatónál fut, a szűrésnek még a hálózat elhagyása előtt meg kell történnie.
- A modell válaszánál: a kimenetet megjelenítés előtt újra ellenőrizni kell, mert a modell a kontextusból vagy a tanítóadatból is visszaadhat személyes adatot.
- A naplóknál és a monitorozásnál: a hibakereséshez mentett promptok és válaszok gyakran a legkevésbé védett személyesadat-gyűjtemények egy cégnél.
A négy pont mindegyikén ugyanaz a döntés születik: törölni, címkére cserélni vagy álnevesíteni kell az adatot. Egy ügyfélszolgálati asszisztensnél például jól működik, ha a promptban a nevek álnevesített azonosítóra cserélődnek. A modell így értelmes választ tud adni, a felhasználónak megjelenő végleges szövegbe pedig a rendszer visszaírja az eredeti nevet. A külső modell így soha nem látja a valódi adatot.
Mit vár el a GDPR és a NAIH
A NAIH banki jelentése a magyar gyakorlatra nézve a legkonkrétebb hatósági forrás. A főbb elvárások:
- Az AI-hoz kapcsolódó adatkezelésnél érvényesíteni kell a GDPR adattakarékossági, átláthatósági és célhoz kötöttségi elvét.
- Ha a betanításhoz csak személyes adat használható, meg kell vizsgálni a jogalapot vagy a GDPR 6. cikk (4) bekezdése szerinti, a célok összeegyeztethetőségére vonatkozó feltételeket, és dokumentálni kell az adatok forrását.
- A hatóság azt javasolja, hogy a modellek betanítása alapvetően anonim adatokkal történjen, ha a cél így is elérhető.
- A banki szektorban a betanítás előtt gyakran alkalmaznak álnevesítést vagy anonimizálást.
Az Európai Adatvédelmi Biztos generatív AI-ról szóló, 2025 októberében frissített iránymutatása ehhez két dolgot tesz hozzá. Az adattakarékosság elve megköveteli, hogy mindig megvizsgáld, elérhető-e a cél személyes adatok helyett szintetikus vagy már anonimizált adatokkal. Az érintettek jogainak érvényesülését pedig a rendszer teljes életciklusán át biztosítani kell, a fejlesztéstől az üzemeltetésig.
Két uniós dokumentum a „kész modell” kérdését is érinti. Az EDPB 28/2024. számú véleménye szerint a személyes adatokkal betanított AI-modellek nem minden esetben tekinthetők anonimnak, és ezt mindig eseti alapon kell megítélni. Az EDPB emellett 2026. július 8-án elfogadta az anonimizálásról szóló 2/2026. számú iránymutatást, amely pontosítja, mikor tekinthetők az adatok valóban anonimnak. Ha az adatkezelésed arra épül, hogy az adat anonim, az iránymutatás szerint vizsgáld felül a megoldásodat, és ehhez vonj be adatvédelmi tisztviselőt vagy adatvédelmi jogászt.
A tágabb adatvédelmi kérdéseket az AI alkalmazásának adatvédelmi kihívásairól szóló útmutatónkban gyűjtöttük össze.
Hogyan ellenőrizd, hogy a védelem működik
Az EDPB 28/2024. számú véleménye szerint az anonimitás megállapításához két dolognak kell teljesülnie, észszerűen valószínűsíthető eszközökkel mérve. A személyes adat modellből történő közvetlen kinyerésének valószínűsége jelentéktelen legyen, és a lekérdezésekkel történő adatszerzésé is. A felügyeleti hatóság az adatkezelő dokumentációját is vizsgálja, beleértve a fejlesztési szakaszban alkalmazott védelmi megoldásokat. Vagyis nem elég, hogy a védelem működik: bizonyítani is kell. Mi a következő ellenőrzési sort használjuk:
- Kézzel jelölt tesztminta: néhány száz valódi, a saját folyamataidból vett dokumentum, amelyben egy munkatárs megjelöli az összes személyes adatot. Ez a viszonyítási alap.
- Felismerési arány típusonként: a nevekre, címekre, azonosítókra és szabad szöveges egészségügyi adatokra külön-külön mérni kell, hány százalékot talál meg a rendszer. Az átlag elfedi a gyenge pontokat.
- Téves riasztások aránya: ha a rendszer túl sokat takar ki, a szöveg használhatatlanná válik, és a munkatársak megkerülik a szűrőt.
- Újraazonosítási próba: egy belső csapat megpróbálja a maszkolt vagy általánosított adatból kitalálni, kiről van szó, más elérhető adatok felhasználásával. Kis cégnél és ritka kombinációknál ez gyakran sikerül.
- Szivárgásteszt a modellen: célzott promptokkal megpróbálni kicsalni a modellből vagy a tudásbázisból a személyes adatokat.
- Dokumentálás és ismétlés: az eredményeket, a döntéseket és a fennmaradó kockázatot írásban rögzíteni kell. A tesztet minden modellváltáskor és új adatforrás bekötésekor meg kell ismételni.
Ha a teszt során mégis kiderül, hogy személyes adat szivárgott, az adatvédelmi incidenskezelés szabályai lépnek életbe. Erről az AI-rendszerek incidenskezeléséről szóló cikkünkben írtunk részletesen.
Technikai és szervezési intézkedések, amelyek csökkentik a kitettséget
A GovTech útmutatója szerint a személyes adatok kitettségét adattakarékossággal, automatizált adatfeltárással, tokenizálással, NER-alapú kitakarással, a tárolt adatok titkosításával és rendszeres adatvédelmi auditokkal lehet csökkenteni. Egy magyar középvállalatnál ez a gyakorlatban így néz ki:
- Adattakarékosság a forrásnál: csak azokat a mappákat, táblákat és mezőket kösd be az AI-rendszerbe, amelyekre a feladathoz tényleg szükség van. A teljes fájlszerver indexelése szinte mindig túl sok.
- Adatleltár és felelős: minden adatforrásnak legyen gazdája, aki eldönti, mi kerülhet be. Ennek kereteit az AI-adatirányításról szóló írásunk mutatja be, az ügyfél- és partnertörzsek rendbetételét pedig a mesteradat-kezelésről szóló cikk.
- Hozzáférés-kezelés: a RAG-rendszer csak azt mutassa meg a felhasználónak, amihez az eredeti forrásban is joga van. Az álnevesítési kulcsokhoz és a nyers adatokhoz pedig erős hitelesítéssel lehessen csak hozzáférni. A többfaktoros hitelesítés és a GDPR kapcsolata azért fontos, mert egy ellopott jelszó minden maszkolást hatástalanít.
- Titkosítás és elkülönítés: a kulcsokat és az eredeti adatokat külön rendszerben, külön jogosultságokkal kell tárolni.
- Szerződéses kontroll: külső modellszolgáltatónál ellenőrizd, mire használja fel a beküldött adatokat, hol tárolja őket és meddig.
- Képzés és házirend: a munkatársak tudják, mit szabad és mit nem szabad bemásolni egy AI-eszközbe, és hogy ehhez melyik, a cég által jóváhagyott eszközt használhatják.
- Rendszeres audit: negyedévente vagy minden nagyobb változtatás után.
A mi nézőpontunk
A legtöbb cég úgy kezdi a személyes adatok védelmét, hogy keres egy „PII-szűrő” eszközt, és beköti. Ez jellemzően kevés, mert a kérdés nem az, hogy melyik eszköz takar ki több nevet, hanem az, hogy melyik adat melyik ponton miért kerül be a rendszerbe.
Mi ezért az üzleti céllal kezdünk. Ha tudjuk, hogy egy ügyfélszolgálati asszisztensnek mire van szüksége, eldönthető, hol elég a maszkolás, hol kell álnevesítés a visszakereséshez, és hol érdemes eleve anonim vagy szintetikus adattal dolgozni. Ezután mérünk a cég saját, magyar nyelvű anyagain, és csak utána választunk technológiát, szállítófüggetlenül.
A governance, az emberi felügyelet és a naplózás nálunk nem utólagos kiegészítés, hanem az első pilot része. Egy jól dokumentált, kis lépésekben bevezetett megoldás gyorsabban jut el éles használatba, mint egy nagyra tervezett rendszer, amelyet a jogi ellenőrzés után át kell építeni.
Zsolt
Így segítünk a bevezetésben
Ha most tervezed az első AI-asszisztenst vagy tudásbázist, és tudni szeretnéd, hol vannak a személyes adatok a folyamataidban, az AI Discovery Workshop jó kiindulópont. Egyszeri díja 390 000 Ft. A workshopon a vezetőkkel és az IT-val közösen azonosítjuk és rangsoroljuk az AI-lehetőségeket, és már ekkor felmérjük az adatvédelmi kockázatokat is.

A folytatásban kontrollált AI-bevezetés keretében lehetőségfelmérést és pilotot viszünk végig: a személyesadat-felismeréstől a mérésen át a dokumentálásig. Ha már működő rendszered van, az AI compliance és átvilágítás szolgáltatásunkkal megnézzük, hol szivárognak adatok, egyedi igényekre pedig AI-megoldást fejlesztünk beépített védelemmel.
Gyakori kérdések
Elég, ha a nagy nyelvi modellt megkérem, hogy ne mentse a személyes adatokat?
Nem elég. A modellnek adott utasítás nem technikai kontroll: a prompt és a válasz így is átmegy a szolgáltatón, és bekerülhet a naplókba. A személyes adatokat még a modellhez küldés előtt kell kiszűrni vagy álnevesíteni, a választ pedig megjelenítés előtt újra ellenőrizni.
Ha álnevesítem az adatokat, még vonatkozik rájuk a GDPR?
Igen. Az EDPB szerint az álnevesítés csak csökkenti a személyhez köthetőséget, nem szünteti meg, ezért az álnevesített adat továbbra is személyes adat. Az álnevesítés így is csökkenti a kockázatot, és jó gyakorlatnak számít, de a jogalapra, a tájékoztatásra és az érintetti jogokra vonatkozó kötelezettségek megmaradnak.
Mennyire pontos az automatikus felismerés magyar szövegeken?
Ez az eszköztől, a dokumentumtípustól és az adatfajtától függ, ezért általános számot nem érdemes elfogadni. A kötött formátumú azonosítókat a szabályalapú módszerek jól megfogják, a ragozott nevek és a szabad szöveges leírások nehezebbek. A megbízható választ egy saját dokumentumokon végzett, kézzel ellenőrzött teszt adja meg.
Anonimnak számít egy modell, ha a tanítóadatból kivettük a neveket?
Nem feltétlenül. Az EDPB 28/2024. számú véleménye szerint ezt eseti alapon kell megítélni, és a kvázi-azonosítók kombinációja nevek nélkül is lehetővé teheti az újraazonosítást. Ha egy adatkezelés az anonimitásra épül, a döntést adatvédelmi tisztviselővel vagy adatvédelmi jogásszal együtt hozd meg, és dokumentáld.
Források
- GovTech: Mitigating Privacy Risks
- Európai Bizottság: Personal data management in AI systems in practice
- EDPB: Anonimizálás és álnevesítés
- NAIH: jelentés a magyar bankok AI-rendszereinek adatkezeléséről (2025)
- NAIH: az EDPB új iránymutatásai az anonimizálásról
- EDPB 28/2024. számú vélemény az AI-modellekről
- EDPS: generatív AI-iránymutatás, 2025. október
- Többfaktoros hitelesítés és a GDPR