Az AI-projekthez szükséges adatarchitektúra egy üzleti célhoz kötött, auditálható adatvagyont és egy könnyen elérhető, kereshető réteget jelent, amelyből a modellek valós kontextust kapnak. Az első lépés soha nem egy új eszköz beszerzése, hanem az adatvagyon-felmérés és egy jól választott pilot kijelölése. A szabályozási kötelezettségek, köztük az EU AI Act adatminőségi elvárásai, innentől kezdve beépülnek a tervezésbe, és ebben a szakaszban érdemes külső támogatást is fontolóra venni.
Röviden:
- A jó adatarchitektúra gyorsabb döntéshozást és könnyebb integrációt biztosít, ezért stratégiailag kiemelt fontosságú AI-projektekben.
- A pilot adatkészlet kiválasztásánál alapvető a tulajdonos megléte és az adatok tisztasága a hatékony eredmények érdekében.
- A RAG-rendszerek lépései között a forráscsatlakozás, chunkolás és embedding azok fő szerepei a hatékony kereshetőség és válaszadás kialakításában.
- Az adattárházak helyett a lakehouse architektúra kiválasztása előnyös lehet, különösen nem strukturált adatok esetén, egy hibrid megoldás pedig középvállalatoknak kedvez.
- A megfeleléshez a megfelelő naplózás, hozzáférés-kezelés és modellverziózás elengedhetetlen, mert ez nemcsak jogi kockázatot mérsékel, hanem a működést is stabilizálja.
Tartalomjegyzék
- Mi az adatarchitektúra AI-hoz és miért stratégiai döntés
- Adatvagyon felmérése és adatleltár készítése pilotokhoz
- RAG-alapú adatfolyamat: forrástól a vektoros tárolóig
- Lakehouse vagy warehouse: melyik illik az AI-projektekhez
- Megfelelés: GDPR, EDPB és az EU AI Act hatása az adatkezelésre
- Megvalósítás: a pilot, a mérés és a skálázás lépései
- Üzemeltetés: naplózás, verziózás és incidenskezelés
- Stratify AI: hogyan segítünk az adatarchitektúra kiépítésében
- Külső tanácsadó vagy belső fejlesztés: melyik utat válasszuk
- Hogyan induljon el: workshop, pilot és tanácsadás
- Források
- Gyakran ismételt kérdések
Mi az adatarchitektúra AI-hoz és miért stratégiai döntés
Az adatarchitektúra azt írja le, honnan jönnek az adatok, hol tárolódnak, ki fér hozzájuk, és milyen formában jutnak el a modellekhez vagy az azokat kiszolgáló alkalmazásokhoz. AI-kontextusban ez nem egyszerű tárolási kérdés: az architektúra dönti el, hogy egy chatbot pontos választ ad-e, vagy elavult, hiányos információt szolgáltat.
A jól megtervezett adatarchitektúra üzleti szempontból három dolgot hoz. Gyorsabb döntéshozatalt, mert a releváns adat azonnal elérhető formában áll rendelkezésre. Könnyebb integrálhatóságot, mert a rendszerek nem egyedi, ad hoc kapcsolatokon keresztül beszélnek egymással. És valódi kontrollt, mert világos, ki mihez fér hozzá, és mi történik az adattal minden lépésben.
Az architektúra fő elemei jellemzően a következők:
- Adatforrások: a belső rendszerek, dokumentumtárak és külső API-k, amelyekből az információ származik.
- Tárolási réteg: ahol a nyers és feldolgozott adat fizikailag él, legyen az adattó, adattárház vagy lakehouse.
- Metaadat-kezelés: a forrás, verzió, tulajdonos és frissítési dátum nyilvántartása.
- Jogosultságkezelés: ki érheti el az adott adatot, és milyen szerepkör alapján.
- Fogyasztási réteg: az API-k, keresőindexek és vektoros tárolók, amelyeken keresztül az AI-alkalmazás ténylegesen dolgozik az adattal.
Ez az öt elem együtt határozza meg, hogy egy AI-projekt pilot szakaszból eljut-e a vállalati szintű bevezetésig.
Adatvagyon felmérése és adatleltár készítése pilotokhoz
Mielőtt bármilyen AI-pilotot elindítanánk, tudni kell, mi van a házban. Az adatleltár nem bürokratikus gyakorlat, hanem az egyetlen módja annak, hogy reális pilotot válasszunk ahelyett, hogy a legzajosabb belső igényt követnénk.
Egy használható adatleltár legalább az alábbi mezőket tartalmazza minden azonosított adatforrásról:
- Forrás és rendszer: honnan származik az adat, milyen alkalmazásból vagy adatbázisból.
- Tulajdonos: ki felel a tartalom pontosságáért és frissítéséért.
- Érzékenységi szint: tartalmaz-e személyes vagy üzletileg kritikus adatot.
- Frissítési gyakoriság: naponta, hetente vagy ritkábban változik-e.
- Formátum: strukturált táblázat, dokumentum, kép vagy vegyes tartalom.
- Hozzáférési mód: API, fájlmegosztás vagy manuális exportálás szükséges-e hozzá.
A rangsoroláshoz egyszerű, de hatékony képlet: üzleti érték szorozva hozzáférhetőséggel, szorozva a kockázat inverzével. Egy magas értékű, de nehezen hozzáférhető és jogilag kockázatos forrás rosszabb pilot-jelölt, mint egy közepes értékű, de tiszta és jól dokumentált adatkészlet.
A leggyakoribb buktató, hogy a csapatok a legnagyobb adatmennyiséget választják pilotnak ahelyett, hogy a legtisztábbat választanák. Egy másik tipikus hiba a tulajdonos hiánya: ha senki nem felel egy adatforrásért, az frissítés nélkül marad, és a modell hamar elavult válaszokat ad.
Profi tipp: Válassz olyan pilot adatkészletet, amelynek van kijelölt tulajdonosa, még akkor is, ha kisebb és kevésbé látványos, mint a nagy, de gazdátlan adattavak.
RAG-alapú adatfolyamat: forrástól a vektoros tárolóig
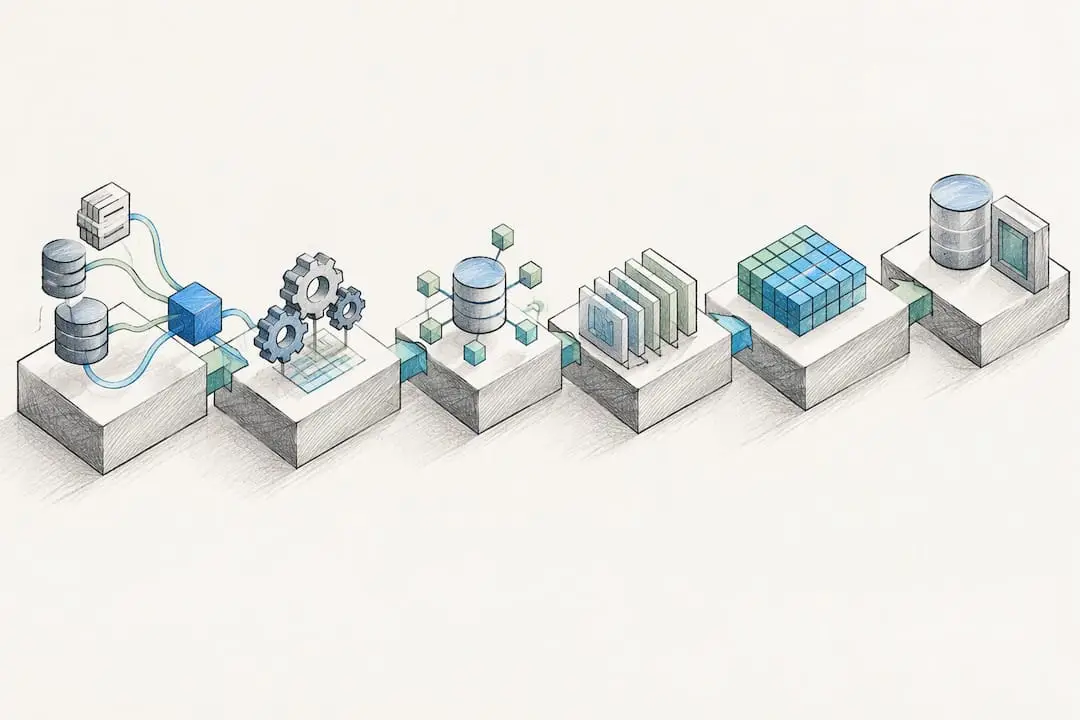
A RAG-rendszerek, vagyis a keresésen alapuló generálás, egy jól meghatározott lépéssorozatra épülnek. A Databricks RAG adatfolyamat leírása és az Unstructured Pipelines dokumentációja gyakorlatilag azonos vázat ad: a forráscsatlakozástól a végső célhelyig minden lépésnek megvan a maga döntési pontja.
A tipikus folyamat a következő elemekből áll:
- Forráscsatlakozás: a dokumentumtárak, adatbázisok vagy API-k bekötése a folyamatba.
- Particionálás és strukturálás: a nyers tartalom feldarabolása kezelhető egységekre, figyelembe véve a formátumot (PDF, táblázat, kép).
- Dúsítás: metaadatok, kulcsszavak vagy összefoglalók hozzáadása a kereshetőség javítására.
- Chunkolás: a szöveg olyan méretű darabokra bontása, amelyek elférnek a modell kontextusablakában, de elég önállóak a helyes válaszhoz.
- Embedding: a szövegdarabok numerikus vektorrá alakítása, amely a jelentésbeli hasonlóságot kódolja.
- Célhelyre írás: a vektorok elhelyezése egy vektoros tárolóban vagy más kereshető célrendszerben.
A chunkolásnál a fő kompromisszum a kontextus és a költség között húzódik: nagyobb darabok pontosabb választ adhatnak, de drágábbak a feldolgozásban és lassabbak a keresésben. Az Unstructured több partitioning stratégiát is kínál, és ezek hatása közvetlenül érezhető a keresési pontosságon.
Az Unstructured dokumentációja szerint a connect → transform → enrich → chunk → embed → destination lépéssor a kanonikus váz a legtöbb RAG-előkészítési projekthez, több célrendszer, köztük vektoros adatbázisok és fájltárak támogatásával. Ez azt jelenti, hogy a döntés inkább az, mely eszközök végzik el a szükséges lépéseket és milyen beállításokkal, nem pedig az, hogy szükség van-e ezekre a lépésekre.
Nem minden adatnak kell vektoros tárolóba kerülnie. Erősen strukturált, táblázatos adatnál gyakran jobb választás egy relációs adatbázis vagy a lakehouse közvetlen lekérdezése, a vektoros tárolót pedig a dokumentumok, e-mailek és egyéb nem strukturált tartalom számára érdemes fenntartani.
Lakehouse vagy warehouse: melyik illik az AI-projektekhez
A hagyományos adattárház erős strukturált adatoknál és kiforrott jelentéskészítésnél, de nehezen kezeli a nem strukturált tartalmat, amire a legtöbb AI-alkalmazás épül. A Fivetran elemzése szerint a lakehouse architektúra ötvözi az adattó rugalmasságát a warehouse ACID-tulajdonságaival és analitikai erejével, ezért gyakran jobb alapot ad AI és RAG munkaterhelésekhez.
A döntést az alábbi szempontok mentén érdemes meghozni:
- Adattípus: ha a projekt jelentős részben dokumentumokra, képekre vagy naplófájlokra épül, a lakehouse rugalmassága előnyt jelent.
- Költségstruktúra: a lakehouse gyakran olcsóbb nagy mennyiségű nyers adat tárolására, mivel a tárolás és a számítási kapacitás elválik egymástól.
- Nyitott táblaformátumok: az Iceberg vagy a Delta Lake típusú formátumok lehetővé teszik, hogy több feldolgozó motor is dolgozzon ugyanazon az adaton, elkerülve a beszállítói zártságot.
- Meglévő beruházás: ha a cég már komoly warehouse-infrastruktúrát üzemeltet strukturált jelentésekhez, a teljes csere ritkán éri meg rövid távon.
Középvállalatok számára a gyakorlatban legtöbbször a hibrid út válik be: egy kis, kontrollált pilot lakehouse-alapokon, miközben a meglévő warehouse tovább szolgálja a klasszikus üzleti jelentéseket, majd fokozatos migráció következik, ahogy az AI-használati esetek bővülnek.
Megfelelés: GDPR, EDPB és az EU AI Act hatása az adatkezelésre
Az adatarchitektúra tervezésekor a megfelelés nem utólagos ellenőrzőlista, hanem beépített tervezési szempont. Az EU AI Act Article 10 iránymutatása kimondja, hogy a magas kockázatú rendszerek adatkészleteinek relevánsnak és reprezentatívnak kell lenniük, és ehhez kapcsolódó végrehajtási dátumok, valamint dokumentációs kötelezettségek 2026-ban lépnek hatályba.
A GDPR oldaláról a kockázat más jellegű, de ugyanolyan valós. Az EDPB útmutatója az LLM-rendszerek adatvédelmi kockázatairól részletesen bemutatja, hogy a személyes adatok bekerülhetnek a tudásbázisokba, a modell kimenetei információt szivárogtathatnak ki, és a visszacsatolási adatok tárolása önálló kockázati pontot jelent. Az útmutató kifejezetten hangsúlyozza, hogy ez nem helyettesíti az adatvédelmi hatásvizsgálatot, vagyis a DPIA-t.
A gyakorlati adatarchitektúrában ez a következő naplózási és dokumentációs elemeket jelenti:
- Forrás és verzió: minden betáplált dokumentum eredete és időbélyege nyomon követhető legyen.
- Hozzáférési napló: ki, mikor és milyen célból érte el az adott adatot vagy a modell kimenetét.
- Incidensnapló: adatvédelmi vagy minőségi probléma esetén visszakövethető legyen a teljes lánc.
- Modellverzió és prompt napló: melyik modellváltozat és milyen bemenet vezetett az adott válaszhoz.
A megfelelő technikai és szervezési intézkedések nem helyettesítik, hanem kiegészítik az adatvédelmi hatásvizsgálatot LLM-alapú rendszereknél.
EDPB, AI privacy risks and mitigations in LLMs
Ez a fajta dokumentáltság nemcsak jogi védelmet ad, hanem gyakorlati előnyt is: ha egy modell rossz választ ad, gyorsan visszakövethető, hogy melyik adatforrás vagy melyik chunk okozta a hibát. Bővebben az AI Act hatásáról és az adatvédelmi kihívásokról is érdemes tájékozódni.
Megvalósítás: a pilot, a mérés és a skálázás lépései
Az AI-ready architektúra nem egy lépésben épül fel. A Databricks ajánlása alapján a legjobban bevált sorrend a következő:
- Üzleti cél és mérőszám meghatározása: mit szeretnénk elérni, és milyen számmal mérjük a sikert, például válaszidő vagy pontossági arány.
- Adatforrás- és tulajdonosi leltár elkészítése: a korábban leírt mezőkkel, hogy tudjuk, mire épül a pilot.
- Jelenlegi adatfolyam és minőség felmérése: hol vannak hiányok, duplikációk vagy elavult rekordok.
- Célarchitektúra és biztonsági modell kialakítása: ki fér hozzá mihez, és milyen technikai réteg szolgálja ki az AI-alkalmazást.
- Kis, kontrollált pilot elindítása: egyetlen üzleti területen, jól körülhatárolt adatkészlettel.
- Mérés és csak ezután skálázás: a pilot eredményei alapján döntünk a bővítésről, nem előbb.
A pilot sikerét nem a technikai bonyolultság méri, hanem az, hogy a kitűzött KPI teljesül-e. Egy dokumentumkereső asszisztensnél ez lehet a válaszidő csökkenése vagy a helyes találatok aránya, egy döntéstámogató rendszernél pedig a felhasználók tényleges elfogadási aránya.
A skálázás előtt érdemes megválaszolni három kérdést: stabil-e az adatminőség a pilot idején, világos-e a jogosultsági modell a bővített körre, és van-e kapacitás a folyamatos üzemeltetésre. Ha ezek közül bármelyik hiányzik, a skálázás korai, és inkább a pilot finomítására érdemes időt szánni.
Üzemeltetés: naplózás, verziózás és incidenskezelés
Az architektúra felépítése után a fenntartás legalább annyira számít, mint a kezdeti tervezés. Az adat- és modellverziózás nélkül lehetetlen visszakövetni, miért változott meg egy AI-alkalmazás viselkedése egyik hétről a másikra.
A gyakorlati üzemeltetés az alábbi elemekre épül:
- Pipeline naplózás: minden feldolgozási lépés, a particionálástól az embeddingig, nyomon követhető legyen.
- Hozzáférés-kezelés: szerepkör alapú jogosultság, amely rendszeresen felülvizsgálatra kerül.
- Változáskezelés: minden adatforrás- vagy modellváltoztatás dokumentált és visszaállítható.
- Rendszeres tesztelés: időszakos ellenőrzés arra, hogy a pipeline még mindig a várt minőségű kontextust adja.
Profi tipp: Állíts be automatikus riasztást arra az esetre, ha egy adatforrás frissítése napokig elmarad, mert ez az egyik leggyakoribb oka annak, hogy egy AI-asszisztens elavult választ ad.
Az incidenskezelés nem elméleti kérdés: ha egy modell téves vagy érzékeny adatot jelenít meg, a csapatnak percek alatt vissza kell tudnia követni a teljes utat a forrástól a kimenetig.
Stratify AI: hogyan segítünk az adatarchitektúra kiépítésében
A Stratify AI üzleti célból indul, nem technológiából: minden ajánlásunk mögött konkrét ROI-szempont és operatív hatás áll. Adatarchitektúra-projekteknél ez azt jelenti, hogy előbb az üzleti use case-t és a mérhető eredményt határozzuk meg, csak utána a technikai réteget.
Munkánk során vendor-független módon választjuk ki a lakehouse, a vektoros tároló vagy a hibrid megoldás közül a cég helyzetéhez illőt, és a governance, a hozzáférés-kezelés, valamint az auditálhatóság minden lépésbe beépül, nem utólagos kiegészítés. Ez összhangban van azzal, amit a Syncbase moduláris vállalati AI platform is képvisel: modulárisan bővíthető, de kezdettől fogva kontrollált architektúra.
Külső tanácsadó vagy belső fejlesztés: melyik utat válasszuk
A külső tanácsadó bevonása gyorsítja a kockázatcsökkentést, és olyan bevált gyakorlatokat hoz be, amelyeket a csapat egyedül hónapok alatt tanulna meg, ha egyáltalán. A belső fejlesztés viszont hosszú távon olcsóbb és rugalmasabb, mert a tudás a cégnél marad, nem egy külső partnernél.
A legjobban működő modell a kettő ötvözete: egy külső szakértő vezeti le a pilotot és rakja le az architektúra alapjait, miközben a belső csapat aktívan részt vesz, hogy utána önállóan tudja üzemeltetni és bővíteni a rendszert.
Hogyan induljon el: workshop, pilot és tanácsadás
Az adatarchitektúra kiépítése nem attól lesz sikeres, hogy minden eszközt egyszerre bevezetünk, hanem attól, hogy a megfelelő sorrendben haladunk. Ehhez kínálunk konkrét, egymásra épülő szolgáltatásokat.
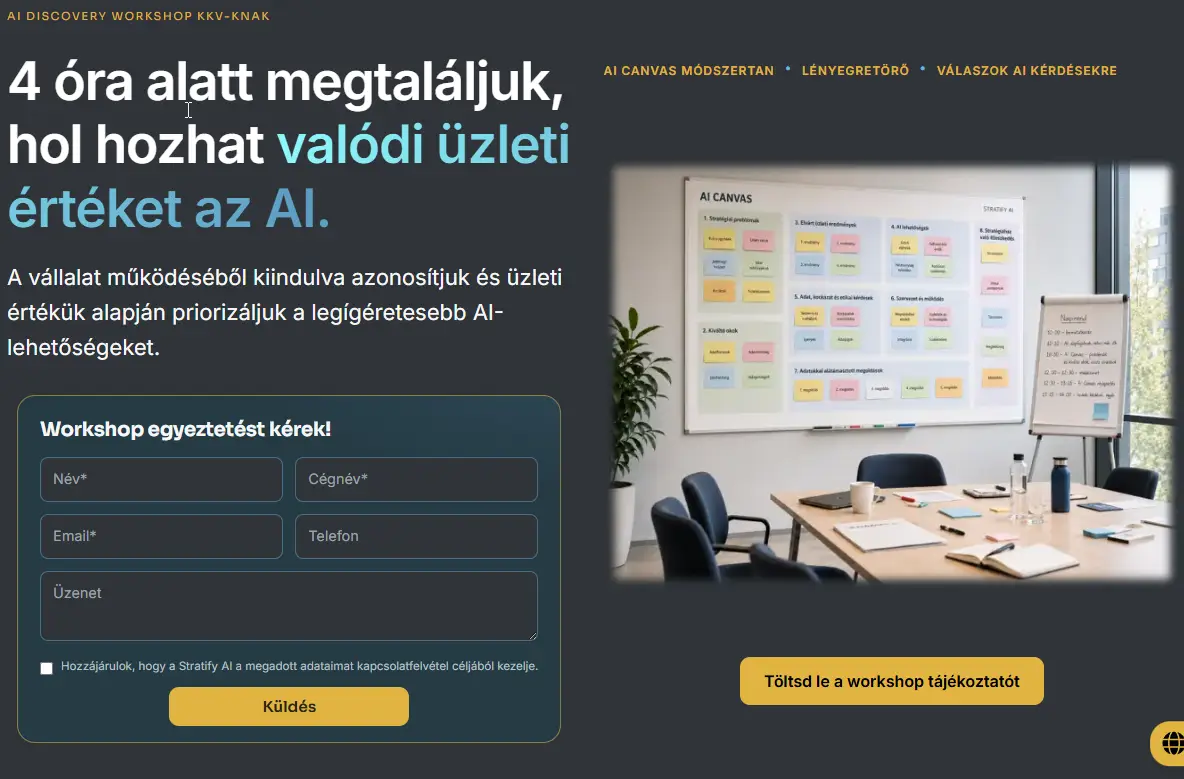
- AI Discovery Workshop: közös munkával azonosítjuk a legértékesebb és leginkább megvalósítható AI-lehetőségeket, és kijelöljük az első pilot adatkészletet.
- AI tanácsadás és AI-stratégia: részletes roadmap készítése az adatarchitektúra felépítésére a pilot után a vállalati szintű bevezetésig.
- Kontrollált AI-bevezetés: a pilot, az adatvagyon-felmérés és az auditálás lépéseinek vezetése kockázatkontrollal.
Egy sikeres pilot után az első 90 napban jellemzően kirajzolódik, mely adatforrások és folyamatok érdemesek a bővítésre, és melyek igényelnek további tisztítást. Ha szeretné felmérni, hol tart a cége, kezdje az AI Discovery Workshoppal, vagy vegye fel velünk a kapcsolatot a kontrollált AI-bevezetés oldalán árajánlatért.
Források
- Databricks: quality data pipeline for RAG
- Unstructured Pipelines overview
- EU AI Act implementation guidance (Article 10)
- EDPB: AI privacy risks and mitigations in LLMs
- Fivetran: data lakehouse vs data warehouse
Gyakran ismételt kérdések
Mi a különbség az adattó és az adatarchitektúra között?
Az adattó egy tárolási réteg, míg az adatarchitektúra a teljes rendszer, amely magában foglalja a forrásokat, a metaadatokat, a jogosultságokat és a fogyasztási réteget is. Az AI-projektekhez az utóbbi a meghatározó, mert enélkül a legjobb tárolás is használhatatlan marad.
Mennyi idő alatt épül fel egy AI-ready adatarchitektúra?
Ez erősen függ az adatvagyon állapotától és a kitűzött pilot méretétől, ezért egyetlen általános időtartam nem adható meg megbízhatóan. Egy jól körülhatárolt, tiszta adatkészletre épülő pilot jellemzően hetek, nem hónapok alatt indítható el.
Kötelező-e DPIA-t készíteni RAG-alapú rendszerekhez?
A DPIA szükségességét az adott adatkezelés kockázata dönti el, és az EDPB útmutatója kifejezetten hangsúlyozza, hogy a technikai intézkedések nem helyettesítik a hatásvizsgálatot. Személyes adatot kezelő tudásbázisoknál a DPIA elvégzése a biztonságos megközelítés.
Mikor érdemes lakehouse-t választani warehouse helyett?
Ha a projekt jelentős részben nem strukturált tartalomra, például dokumentumokra vagy naplófájlokra épül, a lakehouse rugalmassága előnyt jelent az elemzés szerint. Sok középvállalat számára a hibrid megoldás a reális első lépés a teljes migráció helyett.
Milyen szolgáltatással kezdje a cégem az adatarchitektúra tervezését?
Az AI Discovery Workshop az a kiindulópont, ahol közösen azonosítjuk a legértékesebb pilotot és a hozzá tartozó adatforrásokat. Innen a kontrollált AI-bevezetés viszi tovább a projektet a pilot és az auditálás felé.