Az LLM megfigyelhetőség magja ez: rögzítsd a teljes hívási láncot, állíts fel folyamatos minőség és biztonsági kiértékelést, és kezdd tracinggel. A legfontosabb jelzőszám a groundedness és a token felhasználás párosa, mert ezek árulják el leghamarabb, ha a modell válaszai elszakadnak a forrásadatoktól vagy megugrik a költség. Az első héten kapcsold be a tracinget, állíts be mintavételt, és futtasd le egy golden dataseten az első kiértékelést.
Röviden:
- Az LLM megfigyelhetőség alapja a teljes hívási lánc rögzítése, különösen a groundedness és a token felhasználás figyelése.
- A hagyományos monitoring nem elég az LLM-ek esetében, mert a modell viselkedését csak telemetria adatok segítenek valós időben nyomon követni.
- A golden dataset és rendszeres offline kiértékelés nélkül nehéz megállapítani, hogy a modellválaszok mennyire felelnek meg az elvárásoknak.
- Bíró-modell alkalmazásával skálázhatóbbá válik a minőség- és biztonságértékelés, de azok torzítását rendszeres emberi ellenőrzéssel csökkenteni kell.
- A naplók és trace-adatok adatvédelme már a gyűjtéskor fontos, különösen érzékeny adatok maszkolásával és hozzáférés-korlátozással.
Tartalomjegyzék
- Mi az LLM megfigyelhetőség és miben különbözik a hagyományos monitoringtól
- Miért nehéz az LLM-ek kiértékelése
- Offline eval és golden dataset: hogyan építsünk hasznos kiértékelő készletet
- LLM mint bíró: előnyök, korlátok és a torzítások kezelése
- Tracing és telemetria: mit rögzítsünk és hogyan
- Kulcsjelek és metrikák, amelyeket rendszeresen figyelni kell
- Eszközválasztás és vendor-semleges integrációs elvek
- Megfigyelhetőség életciklusba építése: gyakorlati bevezetési lépések
- Stratify AI perspektíva és gyakorlati checklist
- Hogyan segít a Stratify AI bevezetni az LLM megfigyelhetőséget
- Szerzői megjegyzések: mit tegyen egy mérnök holnaptól
- Gyakran ismételt kérdések
- Források
Mi az LLM megfigyelhetőség és miben különbözik a hagyományos monitoringtól
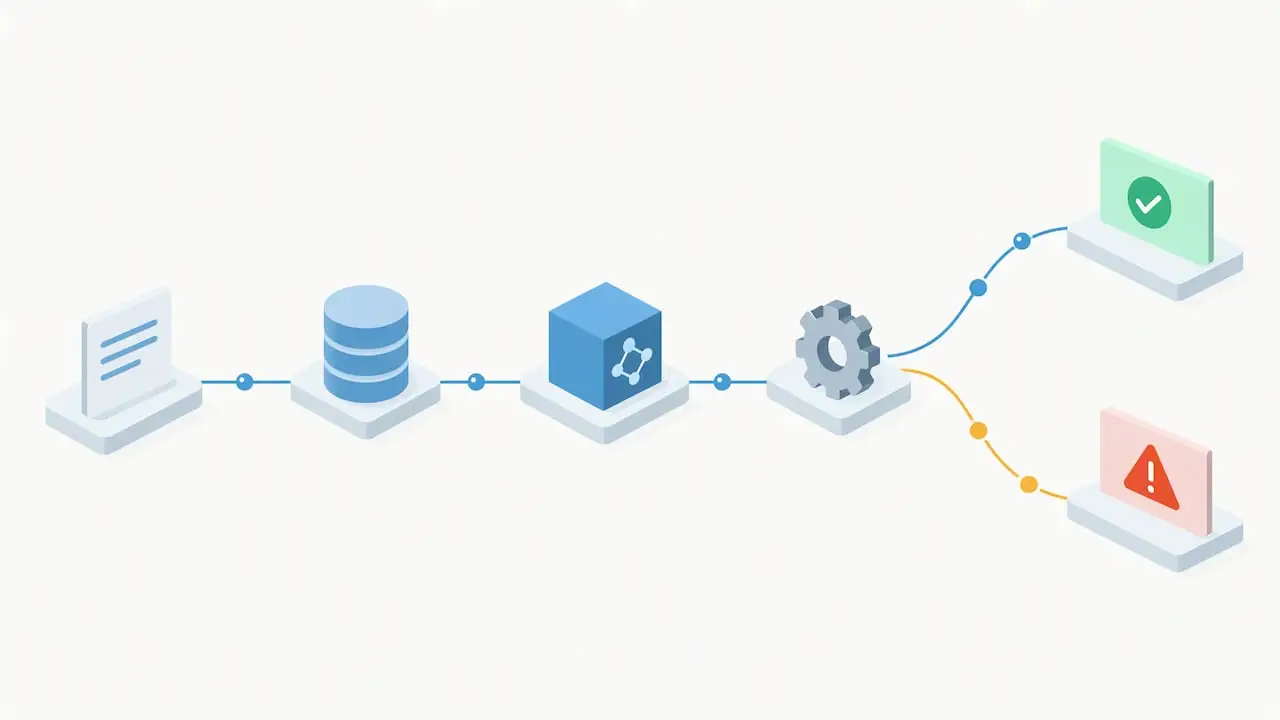
A hagyományos monitoring az uptime-ot, a CPU-terhelést és a hibakódokat követi, ez LLM-eknél kevés. Az LLM observability a promptokat, a válaszokat, a retrieval lépésekben visszaadott szövegdarabokat, a tool hívásokat és ezek span szintű összefüzését egyszerre rögzíti egy trace-be.
Egy production rendszer hibázhat úgy, hogy minden infrastruktúra-metrika zöld: a szerver válaszol, nincs timeout, a CPU normális, mégis a modell rossz forrásból generál választ, vagy fals adatot állít tényként. Ezt csak modellviselkedés szintű telemetria fogja ki, ami a klasszikus APM eszközök vakfoltja.
Miért nehéz az LLM-ek kiértékelése
Az LLM válaszai nem determinisztikusak: ugyanaz a bemenet más kimenetet adhat, ami megnehezíti a hagyományos regressziós tesztelést. A promptok apró módosítása is eltérő választ generálhat, ezért nehéz elkülöníteni, hogy a hibás kimenet a modell, a retrieval vagy egy tool hívás hibájából ered.
A gyökérokot csak a teljes hívási lánc naplózásával lehet megbízhatóan szétválasztani, trace azonosítókkal és korrelációs mezőkkel felépített adatarchitektúra segítségével. Emellett nem csak a sikertelen interakciókat érdemes nyomon követni: a sikeres válaszok adatai adják a baseline-t, amihez a hibákat viszonyítani lehet.
Offline eval és golden dataset: hogyan építsünk hasznos kiértékelő készletet
A golden dataset egy rögzített, emberi szakértő által jóváhagyott referenciakészlet, amelyhez minden új modellverziót vagy promptváltozatot viszonyítunk. Jó golden dataset multi-turn beszélgetéseket, tipikus és szélsőséges (edge-case) kérdéseket tartalmaz, és a válaszokat szakterületi szakember (SME) jelöli meg helyesként vagy hibásként.
A mintavétel nem csak költségkímélés miatt fontos: jól megválasztott minta regressziódetektálásra is alkalmas, ha minden kiadás előtt lefuttatjuk ugyanazt a tesztkészletet.
- A golden datasetet rendszeresen frissítsd valós production példákkal, különben elavulttá válik.
- Építsd be a kiértékelést a CI-pipeline-ba, hogy minden kódváltozás előtt automatikusan lefusson.
- Ütemezz (scheduled) eval futtatást production mintán is, nem csak release előtt.
LLM mint bíró: előnyök, korlátok és a torzítások kezelése
Az LLM-as-a-judge módszertan egy erősebb vagy másik modellt használ arra, hogy minőségi és biztonsági szempontból pontozza a termelésben futó modell válaszait. A 2026-os gyakorlatban ez a megközelítés domináns lett, mert skálázhatóbb, mint a tisztán emberi felülvizsgálat.
A bíró-modellek torzítottak lehetnek: hajlamosak a hosszabb vagy magabiztosabb hangvételű válaszokat jobbnak ítélni, függetlenül a tényleges pontosságtól. Ezt ensembling (több bíró-modell összevetése) és rendszeres emberi mintaellenőrzés kompenzálja. A bíró-pontszámokat ne csak offline tesztkészleten futtasd, hanem illeszd be a production monitoringba is, így a modell élő viselkedését folyamatosan validálod, nem csak a release pillanatában.
Tracing és telemetria: mit rögzítsünk és hogyan
A trace felépítése span-ekből áll: külön span tartozik a modellhíváshoz, a retrieval lépéshez és minden tool híváshoz, ezek egy közös trace azonosítóval kapcsolódnak össze. Az OpenTelemetry GenAI konvenciók szabványosítják, mely attribútumokat exportáljuk: modellnév, token felhasználás, finish reason és az output típusa.
A sampling döntés egyensúly kérdése: minden hívás teljes naplózása drága és adatvédelmi kockázatot növel, túl ritka mintavétel pedig elfedi a ritka, de súlyos hibákat.
- Rögzítsd minden span-hez a modellnevet, a token számokat és a finish reasont.
- Válassz adaptív mintavételt: magasabb arány hibajelzés vagy anomália esetén.
- Maszkold a személyes és üzleti érzékeny adatokat már a naplózás pillanatában.
Profi tipp: Vezess be korán OTLP exportot, mert az OpenTelemetry GenAI szabványok gyorsan válnak alapkövetelménnyé a trace-interoperabilitáshoz.
A naplók hozzáférését role alapú jogosultsággal (RBAC) korlátozd, mert a promptok és válaszok mintavétel közben is tartalmazhatnak érzékeny személyes vagy üzleti adatot.
Kulcsjelek és metrikák, amelyeket rendszeresen figyelni kell
A generálási minőséget négy mutató írja le: a groundedness azt méri, mennyire támaszkodik a válasz a forrásadatra, a relevance a kérdéshez való illeszkedést, a coherence a logikai felépítést, a fluency a nyelvi minőséget. A Microsoft Foundry monitoring gyakorlata ezeket evaluatorokkal méri, és Insights funkcióval ismeri fel az ismétlődő hibamintákat.
Kritikus jelzés: a groundedness és coherence metrikák kombinált követése teszi lehetővé, hogy a drift és a minőségi regresszió korán látható legyen, mielőtt a felhasználók észrevennék.
Biztonsági oldalon figyeld a toxicitást, az érzékeny adat szivárgását és a prompt-injection kísérletek jeleit. Operatív oldalon a latency, a token felhasználás, a hibaarány és a tool-hívások sikertelenségi aránya jelzi előre a kapacitás- vagy integrációs problémákat.
Eszközválasztás és vendor-semleges integrációs elvek
Egy observability eszköz alapkövetelménye három dolog: OTLP alapú adatbefogadás, trace vizualizáció, és egy evaluator pipeline, amely sampling vezérléssel kombinálja az automatikus és emberi kiértékelést. Open-source megoldás nagyobb kontrollt ad az adatok felett, cloud alapú szolgáltatás gyorsabb bevezetést, de figyelni kell, hová kerülnek a promptok és a completions.
Költség szempontjából a sampling aránya közvetlenül befolyásolja a tárolási és feldolgozási díjat, adatvédelem szempontjából pedig az számít, hol fut a maszkolás: a kliens oldalon vagy az eszköz szerverén. Elvárás, hogy a trace, a kiértékelés és a riasztás egy rendszerben, konzisztens adatmodellel működjön együtt.
Megfigyelhetőség életciklusba építése: gyakorlati bevezetési lépések
A telemetriát már az ötletfázisban tervezd meg, ne a production bevezetés után ragaszd rá. A kód életciklusához hasonló szemlélet azt jelenti, hogy a mezőket és az eval kritériumokat a kezdetektől rögzítjük, majd CI-integrált offline eval és ütemezett production mintavétel épül rá.
Az alerting egyszerű szabályokkal induljon: groundedness zuhanás, token felhasználás hirtelen megugrása vagy tool-hívás sorozatos sikertelensége azonnali riasztást váltson ki. Hasznos kiegészítés az ütemezett red-team teszt és az igény szerinti insight-vizsgálat is.
Stratify AI perspektíva és gyakorlati checklist
Magyar KKV-k AI-projektjeiben azt látjuk, hogy a megfigyelhetőség hiánya a leggyakoribb oka annak, hogy egy pilot nem jut el a production fázisig. Minimum checklist, amit minden bevezetés előtt javasolunk: tracing bekapcsolása, mintavételi arány meghatározása, golden dataset összeállítása, eval pipeline beállítása és hozzáférés-korlátozás a naplókon.
Ajánlott indulási sorrend: egy AI Discovery Workshop a célok és kockázatok feltérképezésére, majd egy pilot, és csak ezután a teljes monitoring beállítása.
Hogyan segít a Stratify AI bevezetni az LLM megfigyelhetőséget
Üzleti célból, nem technológiai divatból indulunk: azonosítjuk, melyik AI-folyamat hordozza a legnagyobb kockázatot, és oda építünk megfigyelhetőséget, mielőtt a hiba production incidenssé nőne. Szolgáltatásaink közé tartozik az AI Discovery Workshop, a kontrollált AI-bevezetés pilot és lehetőségfelmérés formájában, valamint a Syncbase moduláris vállalati AI platform, amely governance elemekkel is integrálható.
Egy rövid pilot végén konkrét mérőszámokat és egy használható roadmapet adunk át, nem csak egy demót. Ha szeretnéd feltérképezni, hol tart a saját rendszered megfigyelhetősége, foglalj egy AI Discovery Workshopot.
Szerzői megjegyzések: mit tegyen egy mérnök holnaptól
Ha egyetlen dolgot csinálnál meg holnap, az a tracing bekapcsolása legyen, azt követi az offline eval egy kis golden dataseten, majd egy riasztás a groundedness zuhanására. A leggyakoribb hiba, amit látok: a naplók túl sok adatot tartalmaznak maszkolás nélkül, vagy épp fordítva, nincs semmilyen mintavétel, és a csapat vakon repül production-ben.
A kiértékelés nem egyszeri feladat, hanem folyamatos fegyelem: a modell és a felhasználói minták is változnak.
— Zsolt
Gyakran ismételt kérdések
Mi a különbség az LLM observability és az LLMOps között?
Az LLM observability a modell viselkedésének megfigyelésére és mérésére fókuszál, tracing, metrikák és kiértékelés útján. Az LLMOps szélesebb fogalom, amely a teljes életciklust lefedi a fejlesztéstől a deploymentig, és az observability ennek egyik eleme.
Milyen metrikákat mérjen egy LLM alkalmazás elsőként?
Elsőként a groundedness-t, a relevance-ot és a token felhasználást érdemes mérni, mert ezek jelzik leghamarabb a minőségromlást vagy a költségnövekedést. A Microsoft Foundry gyakorlata ezeket generation quality evaluatorokkal követi.
Mennyire megbízható az LLM mint bíró módszer?
Az LLM-as-a-judge hatékony és skálázható, de torzítható, például a hosszabb válaszokat hajlamos jobbnak ítélni. Ensembling és rendszeres emberi mintaellenőrzés csökkenti ezt a kockázatot a 2026-os OWASP ajánlások szerint.
Mire figyeljünk a megfigyelhetőségi naplók adatvédelmében?
A promptok és válaszok érzékeny személyes vagy üzleti adatot tartalmazhatnak, ezért maszkolás és szigorú hozzáférés-korlátozás szükséges már a naplózás pillanatában. Ez kiemelt kockázati terület minden production LLM rendszerben.
Hogyan kezdjünk hozzá egy KKV-ban az LLM megfigyelhetőség bevezetéséhez?
Egy rövid felmérés vagy workshop segít feltérképezni a kockázatokat és kijelölni az első mérendő metrikákat, mielőtt a teljes tracing és eval pipeline kiépülne. Ehhez illik egy AI Discovery Workshop vagy egy kontrollált AI-bevezetés első lépésként.
Források
- OWASP Top 10 for LLM Applications 2026
- OpenTelemetry GenAI semantic conventions
- What Is LLM Observability? – Apache Doris blog