Az adatcímkézés stratégia egy üzleti célokhoz igazított, mérhető címkézési program, nem csupán technikai feladat. A jól felépített megközelítés pontosabb modellezést, kevesebb torzítást és auditálható dokumentációt eredményez, összhangban a NIST és az AI Act elvárásaival. Ezt a programot visszük gyakorlatba olyan vállalatoknál, ahol az adatminőség közvetlenül üzleti eredményben mérhető.
Röviden:
- A címkézési stratégia legyen üzleti célokra szabott és mérhető, nem csupán technikai feladat, így biztosítva a modell megbízhatóságát.
- A címkézési módszer kiválasztása az adat mennyiségétől, kockázatától és szakértelemtől függ, a hibrid és LLM-asszisztált folyamatok hatékonyabbak lehetnek nagy volumen esetén.
- A folyamatos minőségellenőrzés a címkézett adatok egyezésének mérésével, mintavételes felülvizsgálattal és verziózással biztosítja a szervezet számára a megfelelőséget.
- A dokumentációban rögzíteni kell a célokat, forrásokat, címke-definíciókat és változásnaplókat, hogy az adathalmaz évekkel később is visszakövethető legyen.
- Az AI Act 10. cikke szerint a high-risk adatkészleteknek reprezentatívnak, hibamentesnek és jól dokumentáltnak kell lenniük, ezeket vállalati szinten folyamatosan nyomon kell követni.
Tartalomjegyzék
- Az adatcímkézés fogalma és típusai: mikor melyik megközelítést válasszuk
- Minőségmérés és ellenőrzés: hogyan tartsuk fenn a címkék pontosságát
- Adat- és címkegovernance: mit dokumentáljunk és hogyan maradjunk auditálhatók
- Human-in-the-loop, aktív tanulás és zárt hurok a skálázható minőségért
- Stratégiaépítés lépésről lépésre: priorizálás, pilot és skálázás
- Hogyan visszük gyakorlatba ezt az elvrendszert
- Adatvédelmi és etikai megfontolások az adatcímkézés során
- Humán és gépi munkaerő összehangolása a hatékonyság érdekében
- Szektor-specifikus kihívások: egészségügy, pénzügy és azon túl
- Amit a vállalatok tévesen gondolnak az adatcímkézésről
- Első lépés: AI Discovery Workshop a stratégia megalapozásához
- Gyakran ismételt kérdések
- Források
Az adatcímkézés fogalma és típusai: mikor melyik megközelítést válasszuk
A felügyelt tanulás alapja, hogy a modell emberi vagy gépi úton megjelölt mintákból tanulja meg a mintázatokat. Az adatcímkézés nem más, mint ennek a tanítóanyagnak a strukturált, egységes megjelölése: az adatminták elemeinek azonosítása és feliratozása, amiből a rossz gyakorlat egyenesen torzításhoz és pontatlansághoz vezet. Döntéshozói szempontból ez azt jelenti, hogy a címkézési módszer megválasztása nem technikai részletkérdés, hanem olyan döntés, amely a modell üzleti megbízhatóságát alapozza meg.
A címkézés formátuma a feladattól függ. Osztályozásnál egy egész dokumentumhoz vagy képhez rendelünk kategóriát, span- vagy entitáscímkézésnél szövegrészekhez (nevekhez, dátumokhoz, termékkódokhoz), bounding box esetén képi objektumokhoz rendelünk koordinátákat, attribútumcímkézésnél pedig egy már azonosított elemhez kapcsolunk további tulajdonságokat, mint a hangnem vagy a súlyossági szint.
A módszer kiválasztása az adatmennyiség, a kockázat és a rendelkezésre álló szakértelem függvénye:
- Manuális címkézés: ott indokolt, ahol a hibák ára magas (orvosi diagnózis, jogi dokumentum), mert a szakértői ítélet nehezen helyettesíthető.
- Automatikus (szabályalapú vagy modellalapú) előcímkézés: nagy volumen és jól definiált minták esetén gyorsítja fel a folyamatot, de emberi ellenőrzés nélkül kockázatos.
- LLM-asszisztált címkézés: nagy nyelvi modellek javaslatot tesznek a címkére, amit az annotátor csak jóváhagy vagy javít, így jelentősen csökken a kézi munka mennyisége.
- Hibrid folyamat: automatikus előcímkézést kombinál céltudatos emberi felülvizsgálattal, és a legtöbb vállalati esetben ez adja a legjobb arányt sebesség, költség és pontosság között.
A gyakorlatban a DALL keretrendszer is azt mutatja, hogy a data programming, az aktív tanulás és az LLM-asszisztencia kombinációja csökkentheti a címkézési időt úgy, hogy közben a pontosság szinten marad vagy javul. Ez a hibrid logika az, amit stratégiai szinten is érdemes alapértelmezésnek tekinteni, nem kivételnek.
Minőségmérés és ellenőrzés: hogyan tartsuk fenn a címkék pontosságát
A címkézési stratégia csak akkor ér valamit, ha a minőség mérhető és folyamatosan ellenőrizhető. Az első mérőszám az annotátorok közötti egyezés (inter-annotator agreement), amely megmutatja, mennyire következetesen értelmezik ugyanazt a definíciót különböző emberek. Üzleti kontextusban ez nem elvont statisztika: ha két szakértő rendszeresen eltérően címkéz egy kategóriát, az a definíció pontatlanságára vagy a betanítás hiányára utal, és közvetlenül a modell megbízhatóságában csapódik le.
Az auditálási gyakorlat három pilléren nyugszik:
- Mintavételes felülvizsgálat: a címkézett adatok egy részét rendszeresen újraellenőrzik független szakértők.
- Regressziós tesztelés: minden sablon- vagy irányelv-módosítás után visszamérik, nem romlott-e a korábbi adatok minősége.
- Verziózás: minden címkézési útmutató és dataset-változat dokumentált, visszakereshető állapotban marad.
A HITL és zárt hurok architektúra bevezetése egy ipari dokumentumkinyerési projektben 38%-os csökkenést eredményezett a felülvizsgálati terhelésben, miközben az önjavító képesség is jelentősen javult. Ez a szám azt mutatja, hogy a jól megtervezett visszacsatolási hurok nemcsak minőséget, hanem kapacitást is felszabadít.
A folyamatos minőségi metrikák közül három érdemel kiemelt figyelmet. A lefedettség (coverage) azt méri, hogy a teljes adathalmaz mekkora hányada rendelkezik elfogadott címkével. A teljesség (completeness) azt vizsgálja, hogy egy-egy rekordon belül minden szükséges mező ki van-e töltve. A hibaarány (error rate) pedig az auditált minták alapján becsült, ténylegesen téves címkék arányát mutatja. Ezeket a mutatókat érdemes dashboardon követni, nem egyszeri jelentésben, mert a címkézési minőség idővel drift-elhet, ahogy új adattípusok vagy új annotátorok kerülnek a folyamatba.
Az AI Act 10. cikke kifejezetten megköveteli, hogy a magas kockázatú AI-rendszerekhez használt adatkészletek relevánsak, reprezentatívak és lehetőség szerint hibamentesek legyenek. Ez a követelmény gyakorlatilag ugyanazokat a mérőszámokat teszi kötelezővé, amelyeket egy üzletileg felelős csapat egyébként is nyomon követne.
Adat- és címkegovernance: mit dokumentáljunk és hogyan maradjunk auditálhatók
A governance nem bürokratikus teher, hanem az a réteg, amely lehetővé teszi, hogy egy dataset évekkel később is visszakövethető és magyarázható legyen. A NIST tervezete moduláris sablonokat és folyamatos dokumentálást javasol a dataset- és modelldokumentációhoz, ami kisebb vállalatok számára is adaptálható, ha a mezőket a saját kockázati szintjükhöz igazítják.
Egy használható dokumentációs sablon az alábbi mezőket tartalmazza:
- Cél és felhasználási kontextus: milyen modellhez és milyen döntéshez készül az adat.
- Forrás és mintavételi módszer: honnan származik az adat, és hogyan választották ki.
- Címke-definíciók: pontos, egyértelmű leírás minden kategóriához, példákkal.
- Változásnapló: minden módosítás dátummal, indoklással és felelőssel.
- Ismert korlátok: milyen torzítás vagy hiányosság azonosítható a datasetben.
A dokumentáció egy részét érdemes belsőnek tartani (részletes annotátori útmutatók, nyers hibajegyzékek), más részét pedig megosztani partnerekkel vagy auditorokkal (összefoglaló minőségi mutatók, a módszertan leírása). A modularitás kulcs: ha a sablon elemekre bontható, egy új projektnél nem kell újraírni az egészet, csak a releváns blokkokat frissíteni.
Profi tipp: Jelöljön ki egy felelőst minden datasethez, aki nemcsak a létrehozásért, hanem a karbantartásért is felel, különben a dokumentáció pár hónap alatt elavul.
A szervezeti szerepek tisztázása ugyanilyen fontos. Érdemes elkülöníteni a címkézési irányelvekért felelős szakértőt, az operatív annotáló csapatot vezető koordinátort és a minőségbiztosításért felelős auditort, mert ha ezek a szerepek összemosódnak, a hibák észrevétlenül maradnak. Ez a fajta munkamegosztás illeszkedik abba a kontrollált AI-bevezetési gyakorlatba, amelyben a governance a projekt induló szakaszától jelen van, nem utólagos javításként kerül be.
Human-in-the-loop, aktív tanulás és zárt hurok a skálázható minőségért
A HITL (human-in-the-loop) folyamat lényege, hogy a gép és az ember nem egymást helyettesíti, hanem egymás munkáját validálja. Egy jól felépített HITL workflow három elemből áll: a gép előcímkéz vagy javaslatot tesz, az ember jóváhagyja vagy korrigálja, és minden korrekciós esemény rögzítésre kerül, hogy visszakereshető legyen, mely minták okoztak problémát.
Az aktív tanulás ezt a logikát egészíti ki azzal, hogy nem véletlenszerűen választ mintát emberi felülvizsgálatra, hanem célzottan:
- Bizonytalanság-alapú mintavétel (uncertainty sampling): azokat a példákat priorizálja, ahol a modell a legkevésbé magabiztos.
- Bizottsági lekérdezés (query-by-committee): több modellváltozat véleményét veti össze, és ott kér emberi döntést, ahol nagy az eltérés.
- Hibrid keretrendszerek: a DALL és hasonló megközelítések a data programmingot, az aktív tanulást és az LLM-javaslatokat kombinálják, így az emberi kapacitást csak a valóban nehéz esetekre fordítják.
A HITL és zárt hurok architektúra bevezetése egy produkciós dokumentumkinyerési projektben 38%-os csökkenést hozott a felülvizsgálati forgalomban, és érdemben javította a rendszer önjavító képességét.
Human-in-the-Loop Active Learning for Continuous Model Improvement in Enterprise AI Pipelines
A zárt hurok (closed loop) azt jelenti, hogy minden emberi korrekció visszakerül a tanítócsőbe, nem csak egy adott dataset javításaként, hanem a jövőbeli előcímkézés pontosításaként is. Ehhez eseményalapú naplózásra van szükség: minden javítás, elutasítás vagy prompt-módosítás rögzítve kell legyen, különben a csapat nem tudja megkülönböztetni az egyszeri hibát a rendszerszintű problémától. A regresszió elleni védekezés gyakorlati eszköze, hogy minden új modell- vagy sablonverziót egy rögzített tesztkészleten mérnek le, mielőtt élesben bevezetnék, pontosan úgy, ahogy a minőségi audit szakaszban már leírt verziózási elv is megköveteli.
Stratégiaépítés lépésről lépésre: priorizálás, pilot és skálázás
A stratégia nem egyetlen dokumentum, hanem egy ismétlődő döntési ciklus, amely az üzleti hatással kezdődik, és csak utána tér rá a technikai részletekre. Az első lépés a use-case-ek priorizálása üzleti hatás és kockázat alapján: egy olyan mátrix, amely egyik tengelyén a várható üzleti értéket, másikon a megvalósítási kockázatot és adatigényt méri.
A pilot tervezésekor négy kérdésre kell választ adni:
- Scope: pontosan mely folyamatra vagy döntésre vonatkozik a pilot, és mi marad kívül rajta.
- Siker-mutatók: milyen mérhető küszöböt kell elérni ahhoz, hogy a pilot sikeresnek számítson.
- Minimális életképes dataset: mekkora és milyen minőségű adat szükséges az első érdemi teszthez.
- Időtáv: mennyi idő alatt várható el az első kiértékelhető eredmény.
| Szakasz | Fő kérdés | Jellemző kimenet |
|---|---|---|
| Priorizálás | Melyik use-case ad a legnagyobb üzleti hatást a legkisebb kockázattal | Rangsorolt use-case lista |
| Pilot | Elérjük-e a kitűzött minőségi és üzleti küszöböt | Validált vagy elvetett koncepció |
| Skálázás | Fenntartható-e a minőség és a költség nagyobb volumenen | SLA, költségmodell, kapacitásterv |
A skálázásra lépés feltétele, hogy a pilot alatt mért minőségi mutatók (lefedettség, hibaarány, egyezési szint) stabilan tarthatók legyenek nagyobb adatmennyiségnél is. Ehhez tisztázni kell a szolgáltatási szint megállapodást (SLA) a címkézési átfutási időre, a költségmodellt (belső csapat, külső szolgáltató vagy hibrid), valamint azt, hogy a szervezetnek van-e kapacitása a folyamatos governance fenntartására. Ez az a pont, ahol egy részletes AI stratégiakészítési útmutató segíthet strukturálni a döntési folyamatot.
Hogyan visszük gyakorlatba ezt az elvrendszert
Üzleti célokból indulunk ki, nem technológiai trendekből: minden adatcímkézési vagy AI-projektet azzal a kérdéssel kezdünk, hogy a befektetés milyen mérhető üzleti eredményt hoz. Vendor-független megközelítésünk azt jelenti, hogy nem egyetlen eszközgyártóhoz vagy módszerhez kötjük magunkat, hanem a konkrét feladathoz választjuk ki a megfelelő kombinációt a manuális, automatikus és LLM-asszisztált módszerek közül.
Munkánk során kiemelt hangsúlyt kap a governance:
- Minden pilot projekt dokumentált célokkal, mintavételi leírással és változásnaplóval indul.
- A human-in-the-loop folyamatokat eseményalapú naplózással támogatjuk, hogy a korrekciók visszakerüljenek a tanítási ciklusba.
- A megfelelőségi szempontokat (adatminőség, auditálhatóság) a projekt elejétől kezelve építjük be, nem utólagos javításként.
- A szervezeti szerepeket és felelősségeket tisztázni kell a címkézési munka elindulása előtt.
Egy AI Discovery Workshop akkor indokolt, amikor a szervezet még nem tudja pontosan, mely folyamatok rejtenek valódi AI-potenciált, és szeretné ezt üzleti hatás szerint rangsorolni. A pilot projekt indítása akkor következik, amikor már van egy konkrét, körülhatárolt use-case, és a cél az, hogy kis kockázattal, mérhető eredménnyel validálják a koncepciót, mielőtt szélesebb körben elkötelezik magukat mellette. Ez a kétlépcsős logika csökkenti annak esélyét, hogy egy vállalat nagy beruházást tegyen egy olyan irányba, amely végül nem térül meg.
Adatvédelmi és etikai megfontolások az adatcímkézés során
A címkézési folyamat gyakran érzékeny adatokat érint: személyes azonosítókat, egészségügyi vagy pénzügyi információkat, esetenként védett tulajdonságokra utaló jeleket. Az első lépés annak tisztázása, hogy a címkézéshez ténylegesen szükséges-e a teljes, azonosítható adat, vagy elegendő egy anonimizált vagy álnevesített változat. Minél kevesebb érzékeny mező kerül az annotátorok elé, annál kisebb a visszaélés vagy véletlen adatszivárgás kockázata.
Etikai szempontból kritikus kérdés, hogy a címke-definíciók maguk ne kódoljanak torzítást. Ha egy kategória meghatározása már eleve egy adott csoportra nézve hátrányos értelmezést sugall, a modell ezt a torzítást fogja megtanulni, függetlenül attól, mennyire pontosan dolgoznak az annotátorok. Ezért a definíciók felülvizsgálatába érdemes bevonni olyan szakértőt is, aki nem vett részt a sablon megírásában.
Az annotátorok munkakörülményei szintén etikai kérdés, különösen nagy volumenű, kiszervezett projekteknél: a félreérthető utasítások, a túl szoros határidők vagy a visszajelzés hiánya rontja a minőséget és növeti a fásultságból eredő hibák számát. Az AI Act adatkormányzási követelményei ezeket a szempontokat közvetve is érintik, amikor reprezentativitást és hibamentességet várnak el a magas kockázatú rendszerekhez használt adatkészletektől.
Humán és gépi munkaerő összehangolása a hatékonyság érdekében
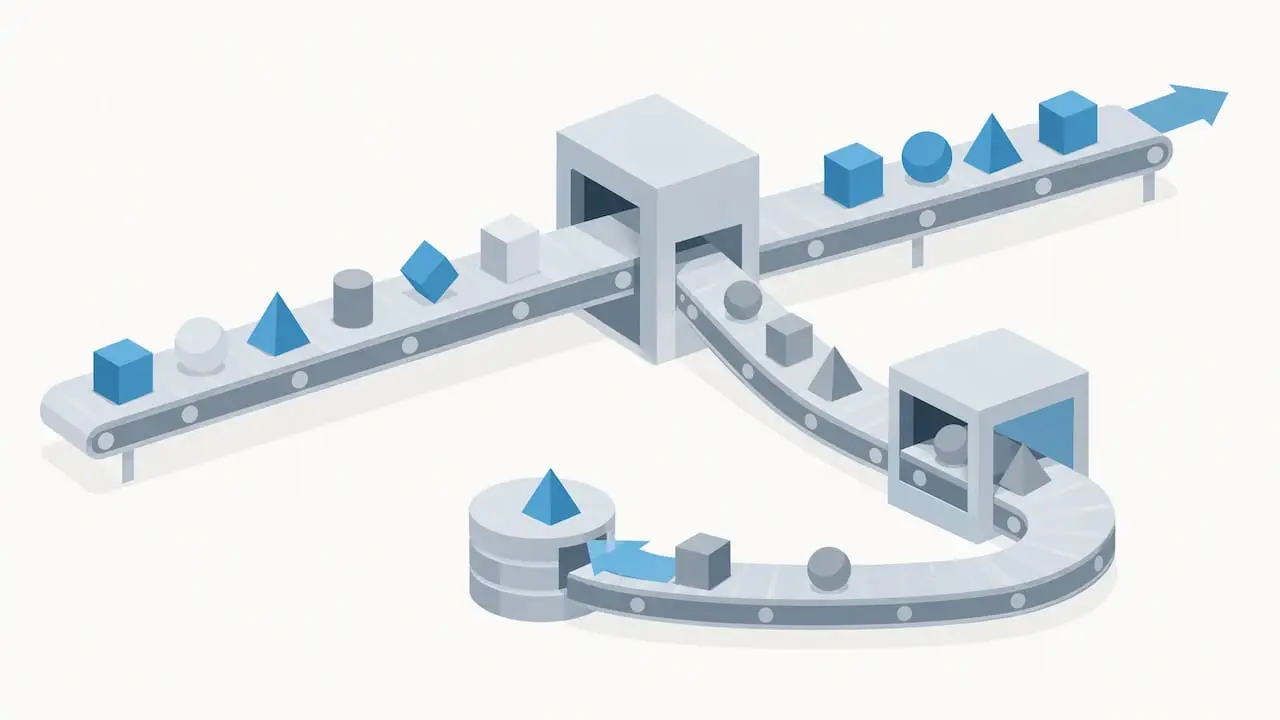
A leghatékonyabb címkézési csapatokban a gép nem versenyez az emberrel, hanem megszűri, mely feladatok igényelnek valódi emberi ítéletet. A gép jól teljesít az ismétlődő, egyértelmű mintázatú eseteknél, míg az ember ott ad hozzáadott értéket, ahol kontextus, árnyalat vagy szakmai tapasztalat szükséges a helyes döntéshez.
Az összehangolás gyakorlati eszköze az aktív tanulás, amely a bizonytalan vagy vitatott eseteket irányítja emberi felülvizsgálatra, míg a magabiztosan és konzisztensen címkézett mintákat automatikusan elfogadja. Ez nem csak időt takarít meg, hanem azt is biztosítja, hogy az annotátorok figyelme a valóban nehéz, tanulságos esetekre koncentrálódjon, nem a rutinfeladatokra.
A hatékonyság optimalizálásának másik eleme a visszajelzési ciklus sebessége. Ha egy annotátor csak hetekkel később szembesül azzal, hogy egy kategóriát rendszeresen félreértett, a hiba addigra már nagy mennyiségű adatban begyűrűzött. A rendszeres, gyors visszajelzés, kombinálva az előző szakaszban leírt eseményalapú naplózással, jelentősen csökkenti ezt a kockázatot és felgyorsítja a csapat tanulási görbéjét.
Szektor-specifikus kihívások: egészségügy, pénzügy és azon túl
Az egészségügyi adatcímkézés különleges terhet ró a folyamatra, mert a hibák közvetlen klinikai következménnyel járhatnak, és a szakértői tudás (radiológus, patológus) szűkös erőforrás. Itt a manuális, szakértő által végzett címkézés aránya jellemzően magasabb marad, az automatizálás inkább az előszűrésben vagy a nyilvánvaló esetek gyors kezelésében segít, nem a végső döntésben.
A pénzügyi szektorban a kihívás más jellegű: a szabályozói elvárások (csalásfelismerés, hitelbírálat) megkövetelik, hogy minden címke visszakövethető és indokolható legyen, mert egy auditor vagy felügyeleti szerv bármikor kérheti a döntés alapjának bemutatását. Ez erősíti a dokumentációs fegyelem szerepét, amelyet a governance szakaszban már részleteztünk: itt a változásnapló és a címke-definíciók pontossága nem kényelmi szempont, hanem megfelelőségi kötelezettség.
Más, kevésbé szabályozott iparágakban, mint a gyártás vagy a logisztika, a fő kihívás inkább a volumen és a változatosság kezelése: nagy mennyiségű, gyakran változó formátumú dokumentumot kell következetesen címkézni. Itt a hibrid, LLM-asszisztált megközelítés általában gyorsabb megtérülést hoz, mert a kockázat alacsonyabb, mint egészségügyi vagy pénzügyi kontextusban, így a gépi előcímkézés nagyobb arányban bízható rá a folyamatra.
Amit a vállalatok tévesen gondolnak az adatcímkézésről
A legtöbb szervezet úgy kezeli a címkézést, mint egyszeri, elvégzendő feladatot a projekt elején, nem mint folyamatosan karbantartandó képességet. Ez a tévedés okozza a legtöbb drift-problémát: egy hónapokkal később érkező új adattípus vagy új felhasználási eset gyakran láthatatlanul rontja a modell teljesítményét, mert senki nem frissíti a címke-definíciókat vagy az auditfolyamatot.
A másik tévhit, hogy a minőség kizárólag technikai kérdés. Valójában a legtöbb címkézési hiba szervezeti eredetű: tisztázatlan felelősség, hiányzó visszajelzési ciklus vagy olyan sablon, amelyet soha senki nem validált a tényleges felhasználási esettel szemben. A NIST és az AI Act dokumentációs elvárásai pontosan ezt a szervezeti hiányosságot célozzák, nem a technikai megvalósítást.
Azt javasoljuk, hogy minden vezető a stratégiát ne a módszer kiválasztásával kezdje, hanem azzal a kérdéssel, hogy ki felel a minőségért hat hónap múlva, amikor a kezdeti lelkesedés már lecsengett.
— Zsolt
Első lépés: AI Discovery Workshop a stratégia megalapozásához
Ha nem ismert, mely folyamatok rejtik a legnagyobb AI-potenciált, egy AI Discovery Workshop segíthet ezt feltárni. Üzleti célokból indulunk, feltérképezzük az operatív kihívásokat és a ROI-potenciált, majd rangsorolt javaslatot adunk arról, mely use-case érdemes pilotra. Ez a strukturált kiindulópont csökkenti annak kockázatát, hogy egy szervezet rossz irányba fektessen be időt és erőforrást. Részletekért és a workshop menetéért keresse fel az AI Discovery Workshop oldalunkat.
Gyakran ismételt kérdések
Mi a különbség a manuális és az LLM-asszisztált címkézés között?
A manuális címkézésnél minden döntést ember hoz, ami magasabb pontosságot biztosíthat kockázatos vagy komplex eseteknél, de lassabb és drágább. Az LLM-asszisztált megközelítésnél a nagy nyelvi modell javaslatot tesz, és az ember csak jóváhagyja vagy javítja, amivel a DALL keretrendszer szerint jelentősen csökkenthető a címkézési idő a pontosság romlása nélkül.
Mennyire csökkentheti a HITL folyamat a felülvizsgálati terhelést?
Egy ipari dokumentumkinyerési projektben a HITL és zárt hurok architektúra bevezetése jelentős csökkenést eredményezett a felülvizsgálati terhelésben, a vonatkozó esettanulmány szerint. Ez azt mutatja, hogy a jól megtervezett visszacsatolási hurok érdemben felszabadítja az emberi kapacitást.
Milyen dokumentációt vár el az AI Act a high-risk adatkészletektől?
Az AI Act 10. cikke megköveteli, hogy a magas kockázatú AI-rendszerekhez használt adatkészletek relevánsak, reprezentatívak és lehetőség szerint hibamentesek legyenek, megfelelő adat-governance mellett. Ez gyakorlatban olyan dokumentációt jelent, amely rögzíti a forrást, a mintavételi módszert és a címke-definíciókat.
Mennyibe kerül egy AI Discovery Workshop?
Az AI Discovery Workshop ára 390 000 forint, egyszeri díjként, a workshop oldalán található leírás szerint. A workshop célja az üzleti célok felmérése és a legígéretesebb AI use-case-ek rangsorolása.
Mikor érdemes pilot projektet indítani a teljes bevezetés helyett?
Pilot projektet akkor érdemes indítani, amikor már van egy konkrét, körülhatárolt use-case, de a szervezet még nem rendelkezik bizonyossággal a minőségről vagy a megtérülésről. A kontrollált AI-bevezetés keretében a pilot kis kockázattal teszteli a koncepciót, mielőtt szélesebb körű skálázásra kerülne sor.
Források
- Mi az adatcímkézés és miért nélkülözhetetlen?
- Extended Outline – Proposed Zero Draft for a Standard on Documentation of AI datasets and AI models
- AI Act — Article 10: Data and data governance
- Human-in-the-Loop Active Learning for Continuous Model Improvement in Enterprise AI Pipelines
- DALL: Data Labeling via Data Programming and Active Learning Enhanced by Large Language Models