
Nem a ranglista első helyezettje lesz az Önnek való embeddingmodell. Az lesz az, amelyik a saját dokumentumain, a saját kollégái kérdéseire a legjobb találatokat hozza, és ezt az elvárt válaszidővel, elfogadható költséggel, az adatvédelmi szabályoknak megfelelően teszi. A gyakorlatban ez így megy: a nyilvános benchmarkok alapján kiválaszt 3–5 jelöltet, aztán egy kis, de valósághű magyar tesztkészleten összeméri őket, végül a győztest pilotban, valós felhasználókkal ellenőrzi. Az alábbi útmutató ezt a folyamatot vezeti végig, döntési szempontokkal, egy számpéldával és egy kipróbálható tesztelési menettel.
Röviden
- Az embeddingmodell határozza meg, hogy a vállalati kereső vagy a RAG-alapú asszisztens egyáltalán megtalálja-e a jó dokumentumrészletet. Ha itt rossz a döntés, a legjobb nyelvi modell sem tudja helyrehozni.
- A nyilvános ranglisták (például az MTEB) jelöltek szűrésére valók. A végső döntés a saját korpuszon, saját kérdésekkel végzett mérésen múlik.
- Magyar nyelvnél és szakszövegnél (jogi, műszaki, pénzügyi) különösen fontos a saját teszt, mert az általános modellek nem mindig értik jól a szakterminológiát.
- A vektorméret a tárhelyet és a memóriát, a maximális bemeneti hossz és a darabolás (chunkolás) a találati minőséget befolyásolja.
- API-n elérhető vagy saját üzemeltetésű modell: ezt a költség, a késleltetés és az adatkezelési szabályok együtt döntik el, nem az ízlés.
Tartalomjegyzék
- Mit csinál az embeddingmodell, és miért ezen múlik a keresés
- A döntés hat szempontja
- Magyar nyelv és szakszöveg: itt dől el a legtöbb projekt
- Vektorméret, kontextushossz és darabolás
- API-n elért vagy saját üzemeltetésű modell
- Így építsen saját tesztkészletet
- Pilot és élesítés utáni követés
- Hogyan látjuk mi
- Modellválasztás szakértői támogatással
- Gyakori kérdések
- Források
Mit csinál az embeddingmodell, és miért ezen múlik a keresés
Az embeddingmodell a szöveget számsorozattá, azaz vektorrá alakítja. A vektor a modell által megtanult jelentésbeli kapcsolatokat tükrözi: két hasonló értelmű mondat vektora közel kerül egymáshoz akkor is, ha egyetlen közös szavuk sincs. Erre épül a szemantikus keresés, a RAG, az ajánlórendszerek, a csoportosítás és az osztályozás.
A vállalati gyakorlatban ez leggyakrabban így jelenik meg:
- Belső tudásbázis és RAG-asszisztens: a munkatárs magyarul kérdez, a rendszer a szabályzatokból, műszaki leírásokból vagy szerződésekből előkeresi a releváns részeket, és a nyelvi modell ezekből fogalmaz választ.
- Ügyfélszolgálati kereső: a beérkező kérdéshez a hasonló, már megoldott jegyeket és tudásbázis-cikkeket ajánlja.
- Dokumentumok csoportosítása és osztályozása: beérkező számlák, reklamációk, ajánlatkérések automatikus kategorizálása.
- Duplikátumkeresés: hasonló termékleírások, ismétlődő ajánlatok kiszűrése.
A RAG-rendszer láncában az embeddingmodell az első szem. Ha a keresés nem hozza fel a választ tartalmazó részletet, a nyelvi modell vagy nem válaszol, vagy, ami rosszabb, magabiztosan téved. Ezért a modellválasztás nem informatikai részletkérdés, hanem a teljes megoldás minőségének alapja. Ha a nagyobb képet keresi, a RAG bevezetéséről komplex cégeknél szóló cikkünk végigveszi az üzleti oldalt is. A vektoralapú keresés és a szemantikus tartalomszerkezet kapcsolata pedig azt mutatja meg, miért számít, hogyan tagolja a szövegeit, ha gépi keresők dolgoznak velük.
A döntés hat szempontja
A benchmark-helyezés csak egy a szempontok közül. A gyakorlatban a feladathoz való illeszkedés, a késleltetési keret és a licencelési modell ugyanúgy eldöntheti a választást. Sokan a „válassz kettőt” elvvel írják le a sebesség, minőség és költség hármasát. Ez jó kiindulópont, de nem merev szabály: a három tényezőt együtt érdemes mérni, mert egy jól megválasztott modell és beállítás mindhárom terén elfogadható lehet.
| Szempont | Mit kérdezzen meg | Miért számít |
|---|---|---|
| Nyelvi lefedettség | Tanították-e a modellt magyar szövegen, és hogyan teljesít vegyes magyar–angol tartalomnál? | A gyengén lefedett nyelveken a találati pontosság érezhetően romolhat. |
| Szakterületi illeszkedés | Érti-e a cég saját szakszavait, rövidítéseit, termékneveit? | Az általános modell a „kötbér” és a „bírság” közti különbséget sem feltétlenül kezeli jól. |
| Maximális bemeneti hossz | Hány token fér egy bemenetbe? | A határ feletti szöveg levágódik, és az a rész kimarad a keresésből. |
| Vektorméret | Hány dimenziós a kimenet, csökkenthető-e? | Ez határozza meg a vektoradatbázis tárhely- és memóriaigényét. |
| Üzemeltetési modell | API-n érhető el, vagy saját szerveren is futtatható? | Ezen múlik az adatok útja, a költségszerkezet és a késleltetés. |
| Licenc | Kereskedelmi célra szabadon használható-e a modell? | Egyes nyílt modellek licence korlátozza az üzleti felhasználást. |
Egy gyakorlati tanács: a szempontokat még a jelöltek keresése előtt rangsorolja. Egy pénzügyi szolgáltatónál az adatok helyben tartása kizáró feltétel lehet, egy webáruház termékkeresőjénél viszont a válaszidő fontosabb mindennél. Ha előre tudja, mi a kizáró feltétel, a jelöltlista fele magától kiesik.
Magyar nyelv és szakszöveg: itt dől el a legtöbb projekt
A nyilvános ranglisták többsége angol nyelvű feladatokon mér, vagy sok nyelv átlagát mutatja. A magyar nyelv ragozó szerkezete miatt egy szónak tucatnyi alakja lehet („szerződés”, „szerződésben”, „szerződéseinkből”), és a modellnek ezeket egy jelentéshez kell kötnie. A jól tanított többnyelvű modellek ezt meglepően jól kezelik, a különbségek viszont akkor jönnek elő igazán, amikor szakszöveg kerül a képbe.
A nyilvános benchmarkok a rövidlistához hasznosak, de vállalati környezetben kötelező a saját, szakterületi tesztkészleten végzett ellenőrzés, mert az általános modellek nem feltétlenül kezelik jól a speciális terminológiát. Néhány tipikus magyar buktató, amire a tesztkészletet érdemes felépíteni:
- Belső rövidítések és kódok: cikkszámok, projektkódok, osztálynevek, amelyek egyetlen nyilvános tanítóadatban sem szerepelnek.
- Kevert nyelvű dokumentumok: magyar szerződés angol mellékletekkel, angol műszaki adatlap magyar megjegyzésekkel. A kérdés magyarul érkezik, a válasz angol szövegben van.
- Jogi és hatósági nyelv: hosszú, mellékmondatos szerkezetek, ahol a lényeg a mondat végén áll.
- Szinonimák és köznyelvi kérdések: a munkatárs „szabadság igénylés”-t keres, a szabályzat „éves rendes szabadság kiadása” címszó alatt írja le.
Ha a tudásbázisa több nyelven íródott, a többnyelvű RAG-ról szóló útmutatónk részletesen bemutatja, miért az adatminőség és az adatirányítás dönt a legtöbb esetben.
Vektorméret, kontextushossz és darabolás
Ez a három műszaki paraméter közvetlenül befolyásolja a minőséget és a költséget. Egy 2026-os benchmarking-tanulmány szerint a vektorméret határozza meg a tárolási és memóriaigényt, a maximális bemeneti hossz feletti szöveg levágódik, a darabolási stratégia pedig közvetlenül hat a keresési minőségre.
Vektorméret: egy gyors számpélda
Egy közepes vállalati tudásbázis könnyen elérheti az egymillió darabot (chunkot). Ha minden vektor 32 bites lebegőpontos számokból áll, a nyers tárigény:
- 768 dimenzió: 1 000 000 × 768 × 4 bájt ≈ 3,1 GB
- 1024 dimenzió: ≈ 4,1 GB
- 3072 dimenzió: ≈ 12,3 GB
Ehhez jön még a keresőindex többletigénye. A nagyobb vektor tehát nem ingyenes: több memória, drágább vektoradatbázis, lassabb keresés. Sok modell ma már lehetővé teszi a kimenet rövidítését vagy kvantálását. Hogy ez mennyit ront a pontosságon, azt megint csak a saját teszt mutatja meg.
Kontextushossz és darabolás
Ha egy 20 oldalas szabályzatot egyben ad át egy rövid bemenetű modellnek, a vége egyszerűen kimarad. Ezért a dokumentumokat darabolni kell, és a darabméret legalább annyira számít, mint maga a modell. Az említett tanulmány darabolási vizsgálatában a minőség nagyjából 32 token körül éri el a platót, és körülbelül 16 token alatt minden modellnél összeomlik. A gyakorlati tanulság: a túl apró darab értelmét veszti, a túl nagy pedig elmossa a lényeget. Érdemes a dokumentum természetes szerkezetét (fejezet, bekezdés, táblázat) követni, és a darabok közé némi átfedést hagyni.
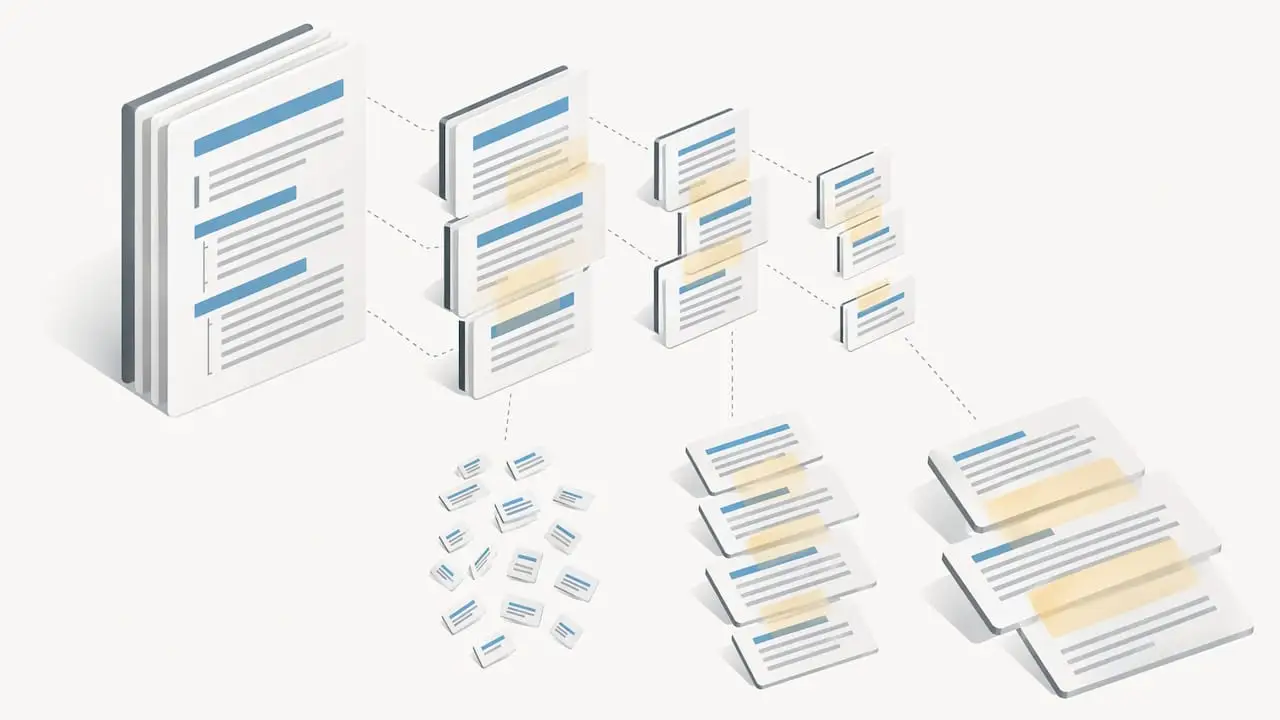
A darabolás és a hibrid (kulcsszavas és szemantikus) keresés finomhangolásáról a fejlett vektorkeresésről szóló cikkünkben írtunk részletesen.
API-n elért vagy saját üzemeltetésű modell
Az API-n elérhető embeddingmodelleket jellemzően a feldolgozott tokenek száma alapján számlázzák, és nem igényelnek saját infrastruktúrát. A saját szerveren vagy privát felhőben futtatott nyílt modellnél nincs tokenenkénti díj, cserébe hardvert, üzemeltetést és karbantartást kell biztosítani.
| Szempont | API-n elért modell | Saját üzemeltetésű modell |
|---|---|---|
| Indulás | Gyors, nincs infrastruktúra | Szerver vagy GPU-kapacitás kell |
| Költségszerkezet | Használatarányos, tokenalapú | Fix infrastruktúra- és üzemeltetési költség |
| Adatok útja | A szöveg a szolgáltatóhoz kerül feldolgozásra | Az adatok a saját környezetben maradnak |
| Késleltetés | Hálózatfüggő | Helyi hálózaton kiszámíthatóbb |
| Testreszabás | Korlátozott | Finomhangolható saját adatokon |
| Modellváltás | A szolgáltató kivezetheti a régi verziót | Ön dönti el, mikor frissít |
Az utolsó sor gyakran elsikkad, pedig fontos. Ha az API mögötti modell verziót vált, a régi és az új vektorok nem keverhetők, vagyis a teljes tudásbázist újra kell vektorizálni. Ezt már a tervezéskor érdemes beárazni.
Az adatvédelmi oldalon a kérdés az, hogy az adott dokumentumtípus elhagyhatja-e a vállalat környezetét. Személyes adatot tartalmazó HR-anyagoknál, ügyféllevelezésnél vagy egészségügyi adatoknál ezt az adatvédelmi tisztviselővel és a jogi területtel közösen kell eldönteni, mielőtt bármilyen külső API-nak elküldené a szöveget. A GDPR és a generatív AI kapcsolatáról szóló útmutatónk és a privát keresés vállalati tudásra témájú cikkünk segít ennek a döntésnek az előkészítésében.
Így építsen saját tesztkészletet
A nyilvános ranglisták a jelöltek szűrésére valók, az illeszkedést a saját korpuszon és lekérdezéseken végzett értékelés dönti el. Egy megbízható összehasonlításhoz nem kell hónapokig tartó projekt. Néhány hét elég, ha a lépések rendben vannak:
- Válasszon reprezentatív dokumentumokat. Néhány száz vagy néhány ezer dokumentum a valós tudásbázisból, minden fontos típusból (szabályzat, szerződés, műszaki leírás, e-mail).
- Gyűjtsön valós kérdéseket. 100–200 kérdés azoktól, akik a rendszert használni fogják, a saját szavaikkal, elírásokkal, köznyelvi fordulatokkal együtt.
- Jelölje meg a helyes választ. Minden kérdéshez a szakterület ismerője jelölje ki, melyik dokumentumrészlet tartalmazza a választ. Ez a legmunkaigényesebb lépés, és ez adja a teszt értékét.
- Rögzítse a darabolást. Minden jelöltet ugyanazzal a darabolási beállítással teszteljen, különben nem a modelleket, hanem a beállításokat hasonlítja össze.
- Mérjen egyszerű mutatókkal. A recall@k azt mutatja, hogy az első k találat között ott van-e a helyes részlet. Az MRR azt, hogy átlagosan hányadik helyen bukkan fel. RAG-nál a recall@5 vagy recall@10 a legbeszédesebb.
- Mérje a válaszidőt és a költséget is. Ugyanazon a teszten rögzítse a kérésenkénti késleltetést és a teljes korpusz vektorizálásának idejét és díját.
- Nézze meg a hibákat egyenként. A számok mögött a tévesztések mintázata a legtanulságosabb: rövidítésnél hibázik, kevert nyelvnél vagy hosszú jogi mondatoknál?
A tesztkészlet ráadásul nem eldobható: később minden modellfrissítésnél, darabolási változtatásnál újra lefuttatható, így regressziós tesztként szolgál.
Pilot és élesítés utáni követés
A laborteszt nem helyettesíti a valós használatot. Egy 4–8 hetes pilot egy jól körülhatárolt felhasználói körrel (például egy osztály vagy egy ügyfélszolgálati csapat) megmutatja, hogyan teljesít a modell a valódi kérdésekkel, amelyekre a tesztkészlet nem gondolt.
Élesítés után a keresési minőséget folyamatosan figyelni kell:
- Visszajelzések: egyszerű „hasznos volt / nem volt hasznos” jelzés minden válasz mellett.
- Üres vagy gyenge találatok: azok a kérdések, amelyekre a rendszer nem talált elég hasonló részletet, gyakran hiányzó dokumentumokra utalnak.
- Rendszeres újramérés: a tesztkészlet negyedéves lefuttatása, különösen új dokumentumtípusok bevonása után.
- Költség és késleltetés: a tokenfelhasználás és a válaszidő havi trendje.
Ha a modell, a darabolás vagy a tudásbázis változik, a mérés mutatja meg, hogy a változás javított vagy rontott. Az élesített AI-megoldások ilyen folyamatos felügyeletét AI-üzemeltetési szolgáltatásunk keretében, monitoringgal és költségkontrollal együtt vállaljuk.
Hogyan látjuk mi
A legtöbb ügyfelünk azzal a kérdéssel keres meg minket, hogy melyik a legjobb embeddingmodell. Mi először azt kérdezzük vissza: mit kell megtalálnia a rendszernek, kinek és milyen gyorsan? Ha ez világos, a modellválasztás már egy mérhető, néhány hetes feladat, nem hitvita.
Vendorfüggetlenül dolgozunk, ezért nincs kedvenc modellünk. Az a jó választás, amelyik a cég saját magyar dokumentumain, a valós kérdéseken a legjobban teljesít, és közben belefér a költségkeretbe és az adatkezelési szabályokba. A governance, az adatbiztonság és a visszakereshetőség nálunk a megoldás része az első naptól, nem utólagos kiegészítés.
Azt is tapasztaljuk, hogy a modell csak egy elem. A darabolás, a dokumentumok minősége, a metaadatok és a hibrid keresés legalább annyit számít. Ezért a modellt sosem önmagában választjuk ki, hanem a teljes keresési lánc részeként, pilotban ellenőrizve, mielőtt a teljes szervezet elé kerül.
Zsolt
Modellválasztás szakértői támogatással
Ha a cége RAG-asszisztenst, belső keresőt vagy dokumentumfeldolgozó megoldást tervez, az embeddingmodell kiválasztása az első lépések egyike. Az AI Discovery Workshopon (egyszeri díja 390 000 Ft) a vezetőkkel és az IT-val közösen azonosítjuk, mely felhasználási esetek hozzák a legnagyobb üzleti értéket, és milyen adat-, nyelvi és biztonsági feltételeknek kell megfelelnie a megoldásnak.

A workshop után kontrollált AI-bevezetés keretében lehetőségfelméréssel és pilottal folytatjuk: saját tesztkészleten mérjük össze a jelölt modelleket, és csak a bizonyítottan működő megoldást visszük éles környezetbe. A kész rendszert AI-megoldásfejlesztési csapatunk integrálja a meglévő vállalati rendszerekbe.
Gyakori kérdések
Elég a nyilvános ranglista alapján embeddingmodellt választani?
Rövidlistához elég, döntéshez nem. A ranglisták általános, gyakran angol nyelvű feladatokon mérnek, a vállalati dokumentumok szakszókincse és nyelve viszont ettől eltér. A végső döntést a saját dokumentumokon és valós kérdéseken végzett mérésre érdemes alapozni.
Kell-e kifejezetten magyar modellt választani?
Nem feltétlenül. A jó többnyelvű modellek magyar szövegen is erősek lehetnek, és a kevert magyar–angol tartalmat is kezelik. Hogy az Ön esetében melyik a jobb, azt a saját tesztkészlet mutatja meg.
Le lehet később cserélni a modellt?
Igen, de a csere a teljes tudásbázis újravektorizálásával jár, mert a különböző modellek vektorai nem keverhetők. Ha a rendszert eleve úgy tervezik, hogy a vektorizálás bármikor újrafuttatható legyen, és van saját tesztkészlet, a csere tervezhető feladat.
Mennyi idő alatt lehet megbízhatóan dönteni?
Egy jól előkészített összehasonlítás reprezentatív dokumentumokkal és 100–200 megjelölt kérdéssel jellemzően néhány hét. Ezt követi a pilot valós felhasználókkal, amely a laborteszt által nem látott eseteket hozza felszínre.
Források
- Snowflake: Embeddings for semantic search and RAG
- Airbyte: Choosing embeddings for AI agents
- Qdrant: How to choose an embedding model
- Splunk: Choosing an embedding model for RAG
- arXiv: Choosing a text embedding model, a practical benchmarking study
- Vector search SEO