
Az LLM-biztonság azt jelenti, hogy a nagy nyelvi modellt és minden rendszert, amelyhez hozzáfér, úgy tervezzük meg és üzemeltetjük, hogy rajta keresztül ne szivárogjon ki adat, és rosszindulatú bemenet se vehesse rá olyan műveletre, amelyre senki nem adott felhatalmazást. Egy középvállalatnál ez négy kérdésen múlik: milyen adat jut el a modellhez, mihez fér hozzá a modell, ki ellenőrzi, amit kiad, és ki felel érte, ha hibázik. Az alábbiakban sorra vesszük a valós kockázatokat, a működő technikai és szervezeti kontrollokat, a szolgáltató átvilágításának kérdéseit, a tesztelést és az irányadó uniós szabályokat.
Röviden
- Az LLM szabad szöveget fogad, és ugyanarra a kérdésre is adhat eltérő választ, ezért a megszokott IT-biztonsági kontrollok szükségesek, de önmagukban nem elegendők.
- A legsúlyosabb kockázatok a prompt injection, az adatszivárgás (a lekérdezésekből és a tanítási adatokból is), az adat- és modellmérgezés, valamint a túl széles jogosultsággal bekötött integráció.
- Az alap a hozzáférés kontrollja: az AI-ügynök ne örökölje automatikusan annak a munkatársnak a jogosultságait, aki használja.
- Külső szolgáltatónál az adatkezelési feltételek és a szerződés döntenek, saját vagy nyílt modellnél a teljes infrastruktúra védelme a cég felelőssége.
- A GDPR 25. és 32. cikke, az adatvédelmi hatásvizsgálat és az EU AI Act együtt adják a jogi keretet.
Tartalomjegyzék
- Mit jelent az LLM-biztonság egy vállalat számára?
- A legfontosabb kockázatok áttekintése
- Külső szolgáltató vagy saját modell: más kockázatok
- Technikai és szervezeti intézkedések, amelyek működnek
- Mit kérdezzen meg a szolgáltatótól szerződés előtt?
- Tesztelés bevezetés előtt és működés közben
- Uniós és magyar szabályok, amelyekre építeni kell
- Hogyan látjuk mi
- Biztonságos LLM-bevezetés lépésről lépésre
- Gyakori kérdések
- Források
Mit jelent az LLM-biztonság egy vállalat számára?
Egy hagyományos üzleti alkalmazás jól körülhatárolt bemenetet kap: egy űrlapmezőbe dátum kerül, egy legördülő listából érték. Az eredmény kiszámítható, ugyanarra a bemenetre mindig ugyanaz. Ezt lehet tesztelni, naplózni és auditálni.
Egy LLM-alapú rendszer másképp működik. A bemenet bármilyen szöveg lehet: egy ügyféllevél, egy feltöltött PDF, egy weboldal tartalma vagy egy belső wiki szócikke. A kimenet valószínűségi, vagyis ugyanarra a kérdésre két futtatás két eltérő választ adhat. Ráadásul a modell ma már ritkán áll magában: dokumentumtárból keres (RAG), e-mailt fogalmaz, CRM-rekordot olvas, és egyre gyakrabban műveletet is végrehajt.
Ebből következik, hogy az LLM-biztonság három rétegből áll:
- A modell és a bemenetek védelme. Mit láthat a modell, és hogyan kezeljük a manipulációs kísérleteket?
- Az integrációk védelme. Milyen rendszerekhez, milyen jogosultsággal fér hozzá a modell vagy az AI-ügynök?
- A működés irányítása. Ki hagyja jóvá a kimeneteket, hogyan mérjük a hibákat, és ki dönt, ha valami félremegy?
A tűzfal, a titkosítás és a jogosultságkezelés továbbra is kell. Az LLM-ek viszont új támadási felületet nyitnak: a nyelvet magát. Aki meg tud írni egy ügyesen megfogalmazott mondatot, az elvben befolyásolhatja a rendszer viselkedését, ha a rendszer erre nincs felkészítve.
A legfontosabb kockázatok áttekintése
Az Európai Adatvédelmi Testület LLM-ekről szóló útmutatója a felhasználói bevitel kockázatai között említi az érzékeny pénzügyi vagy egészségügyi adatok nem szándékos kiszivárgását, a jogosulatlan hozzáférést és azokat a támadásokat, amelyek a modell biztonsági korlátait próbálják megkerülni. Az alábbi táblázat összefoglalja, mit jelentenek ezek a gyakorlatban.
| Kockázat | Mi történik | Tipikus vállalati helyzet | Fő védekezés |
|---|---|---|---|
| Prompt injection | Egy bemenet felülírja a rendszer utasításait | Az ügyfélszolgálati chatbot egy trükkös kérdésre belső információt ad ki | Bemenet- és kimenetszűrés, szűk jogosultságok, utasítások elkülönítése az adattól |
| Közvetett prompt injection | A rejtett utasítás egy dokumentumban vagy weboldalon érkezik | Az asszisztens összefoglal egy beérkezett e-mailt, amely utasítást rejt | A külső tartalom adatként kezelése, műveletek emberi jóváhagyása |
| Adatszivárgás a lekérdezésekből | Munkatársak bizalmas adatot másolnak egy külső eszközbe | Szerződéstervezet vagy bérlista egy nyilvános chatfelületen | Belső AI-szabályzat, jóváhagyott eszközök, automatikus anonimizálás |
| Adatszivárgás a tanítási adatokból | A modell kiad valamit, amit a tanítás során látott | Finomhangolt modell ügyféladatot idéz vissza | Adattisztítás a tanítás előtt, adatminimalizálás |
| Adat- és modellmérgezés | A támadó módosítja a tanító vagy prompt-adatokat | Manipulált dokumentum kerül a tudásbázisba | A tudásbázis forrásainak ellenőrzése, változáskövetés |
| Túl széles jogosultságú integráció | A modell több rendszerhez fér hozzá, mint amennyi a feladathoz kell | Az AI-ügynök a teljes ERP-t írhatja, nem csak egy táblát | Legkisebb jogosultság elve, külön identitás az ügynöknek |
| Hallucináció | A modell magabiztosan téved | Hibás szerződési záradék vagy rossz műszaki adat egy ajánlatban | Forráshivatkozás (RAG), emberi ellenőrzés a kritikus pontokon |
Prompt injection: a nyelv mint támadási felület
Az Óbudai Egyetem LLM-sebezhetőségekről szóló tanulmánya a prompt injectiont az LLM-ek egyik legkritikusabb sebezhetőségének tartja: speciális bemenetekkel kijátszhatók a modell alapvető biztonsági mechanizmusai, ami adatszivárgáshoz vagy jogosulatlan parancsvégrehajtáshoz vezethet. A közvetett változat a veszélyesebb, mert a támadónak nem is kell a rendszerrel beszélnie. Elég, ha a rejtett utasítás egy olyan dokumentumba kerül, amelyet a modell később feldolgoz.
Adatszivárgás két irányból
A szivárgás nem csak abból ered, amit a munkatársak beírnak. Ugyanez a tanulmány rámutat, hogy a modell tanítási adataiból is kiszivároghat információ, ha az előtanítás vagy a finomhangolás során nem megfelelően tisztított, érzékeny adatot tartalmazó korpuszt használtak. Ha a cég saját adataival finomhangol modellt, ez közvetlenül az ő kockázata. Az adatbiztonság alapelveiről szóló összefoglaló jól mutatja, hogy a minimalizálás, a titkosítás és a hozzáférés-szabályozás ugyanúgy érvényes az LLM-be kerülő adatokra, mint bármely más vállalati adatra.
Mérgezés és túl széles integráció
Mérgezéskor a támadó a tanítási vagy prompt-adatokat módosítja, hogy a modell egy adott irányba, például rosszindulatú kimenet vagy kiskapu felé tolódjon. Egy RAG-alapú tudásbázisnál ez nagyon hétköznapi: ha bárki feltölthet dokumentumot, bárki befolyásolhatja a válaszokat. Az EDPB szerint pedig az AI-ügynököknél a nem biztonságos integráció azzal terjeszti ki a támadási felületet, hogy a modell külső rendszerekhez és API-khoz fér hozzá.
Külső szolgáltató vagy saját modell: más kockázatok
Az első stratégiai döntés, hogy a cég felhőben elérhető modellt használ API-n vagy kész felületen keresztül, vagy saját infrastruktúrán futtat nyílt modellt. Az EDPB útmutatója mindkét esetre más kockázatokat emel ki.
| Szempont | Külső LLM-szolgáltatás | Saját vagy nyílt modell üzemeltetése |
|---|---|---|
| Fő kockázat | A szolgáltató adatkezelése, például az adatok modelltanításra való felhasználása | A teljes infrastruktúra védelme a cégre hárul |
| Függőség | Szolgáltatói függés, változó feltételek | Kisebb külső függés, nagyobb belső kompetenciaigény |
| Kontroll | A szerződés és a beállítások szintjén | A hálózat, a hozzáférés és a naplózás teljes egészében |
| Tipikus feladat | Adatfeldolgozói szerződés, beállítások, adatminimalizálás | Modellmérgezés elleni védelem, számítási és biztonsági kontrollok kiépítése |
Egyik út sem eleve biztonságosabb. A saját modell jobb kontrollt ad az adatok felett, de csak akkor, ha a cégnek van csapata a frissítésre, a monitorozásra és az incidenskezelésre. Ha a döntés még nyitott, a saját LLM-üzemeltetés megtérüléséről szóló elemzésünk segít mérlegelni a költséget és a felelősséget.
Technikai és szervezeti intézkedések, amelyek működnek
Az EDPB a technikai eszközök (bemenet- és kimenetszűrés, RAG-architektúra, titkosítás) és a szervezeti intézkedések (belső MI-szabályzat, képzés, szigorú szerepkörök) együttes alkalmazását javasolja, kiegészítve rendszeres red teaminggel és emberi felügyeleti pontokkal. A gyakorlatban ezt öt területre bontjuk.
1. Hozzáférés és identitás
A Nemzeti Kiberbiztonsági Intézet AI-ügynökökről szóló 2026. márciusi közleménye szerint az igazi kihívás nem a viselkedés utólagos korlátozása, hanem a hozzáférés kontrollja, ezért az alapnak az identitás- és hozzáférés-kezelésnek (IAM) kell lennie. A lényeg: az AI ne örökölje automatikusan az emberi jogosultságokat. Az ügynök kapjon saját identitást, csak azokat a rendszereket és műveleteket érje el, amelyek a feladathoz kellenek, és minden hozzáférése legyen naplózva. Ugyanez igaz az emberi fiókokra is, amelyekkel az AI-eszközöket elérik: a vállalati jelszavak és fiókok védelme többfaktoros hitelesítéssel kezdődik, mert egy ellopott adminisztrátori fiókkal a legjobb promptszűrő is megkerülhető.
2. Bemenetek és kimenetek szűrése
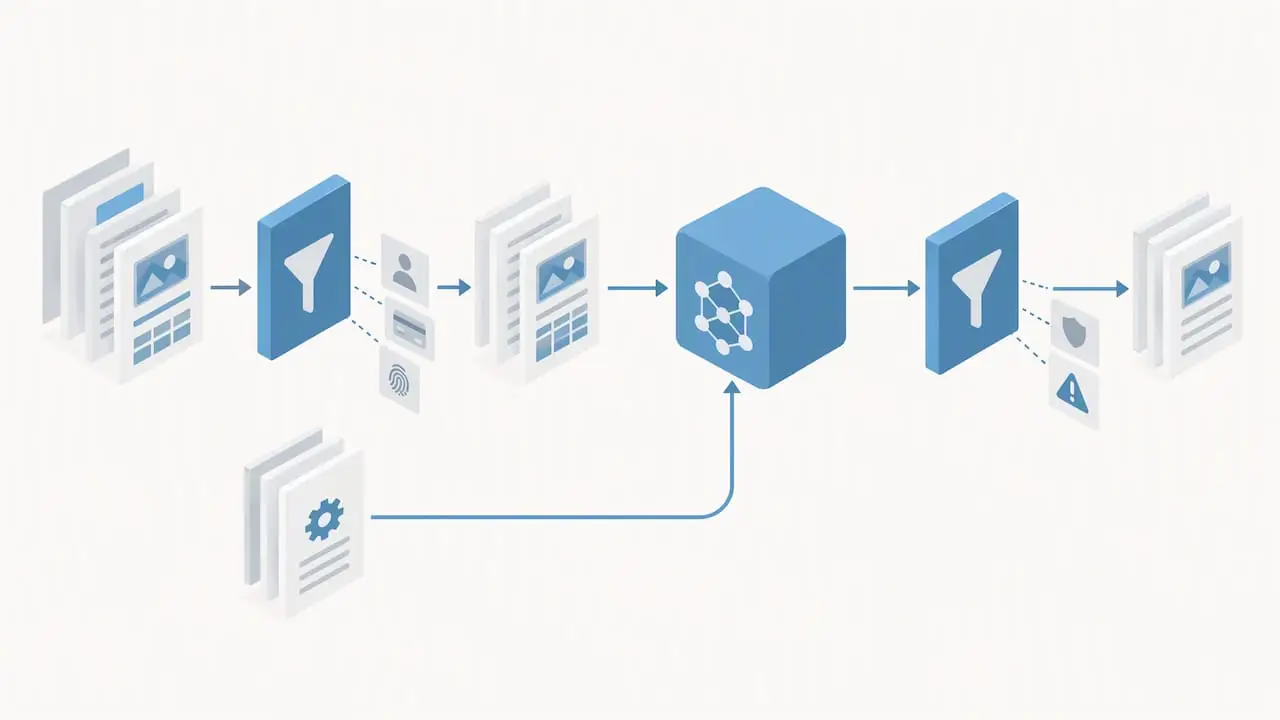
A bemenet oldalon érdemes automatikusan felismerni és anonimizálni az érzékeny adatokat (személyes adatok, bankszámlaszám, egészségügyi információ), mielőtt a modellhez érnek. A kimenet oldalon a szűrő azt nézi, nem tartalmaz-e a válasz belső adatot, és megfelel-e a formai elvárásoknak. A rendszer utasításait technikailag is el kell választani a feldolgozott tartalomtól, hogy egy beolvasott dokumentum ne adhasson parancsot.
3. Titkosítás és adatminimalizálás
Az EDPB a szolgáltatóknak végponttól végpontig tartó titkosítást (például TLS-t) is javasol. Ennél is fontosabb az adatminimalizálás: a modell csak azt az adatot kapja meg, amely az adott válaszhoz kell. Egy RAG-rendszerben ez azt jelenti, hogy a keresés tiszteletben tartja a dokumentumok eredeti jogosultságait. Ha egy munkatárs nem nyithatja meg a bérszámfejtési mappát, az asszisztens se idézzen belőle neki.
4. Emberi felügyelet a kritikus pontokon
Nem minden kimenetet kell ember elé tenni, de azokat igen, amelyek pénzt mozgatnak, ügyfélhez mennek ki vagy jogi következménnyel járnak. Egy árajánlat-generáló rendszerben a modell előkészíti az ajánlatot, az értékesítő hagyja jóvá. Egy dokumentumfeldolgozó rendszerben a bizonytalan mezők kerülnek emberi ellenőrzésre.
5. Szabályzat, képzés, felelősök
A legtöbb szivárgás nem támadásból, hanem jó szándékú munkatársaktól ered, akik egy nyilvános eszközbe másolnak be egy szerződést. Egy rövid, érthető belső AI-szabályzat, amely megmondja, melyik eszköz engedélyezett, milyen adat kerülhet bele és kihez lehet fordulni, többet ér egy hosszú tiltólistánál. Mellé kell egy felelős, aki dönt az új eszközökről, és egy gyakorlati képzés.
Mit kérdezzen meg a szolgáltatótól szerződés előtt?
Külső LLM-szolgáltatásnál a biztonság nagy része a szerződésben dől el. Az alábbi kérdésekre írásos, ellenőrizhető választ érdemes kérni:
- Adatfelhasználás: felhasználja-e a szolgáltató a cég bemeneteit és kimeneteit modellfejlesztésre, és ez kikapcsolható-e szerződésben?
- Adattárolás helye: hol tárolja az adatokat, az EU-n belül vagy kívül, és mennyi ideig?
- Hozzáférés: kik férhetnek hozzá a szolgáltató oldalán, és milyen esetben?
- Alvállalkozók: kik a további adatfeldolgozók, és hol érhető el a listájuk?
- Igazolt kontrollok: milyen biztonsági tanúsítványokat, auditjelentéseket tud bemutatni?
- Naplózás és törlés: kérhető-e a naplók exportja és az adatok igazolt törlése?
- Incidenskezelés: mennyi időn belül és milyen formában értesít adatvédelmi incidensről?
Az adatvédelmi tisztviselőt már a modell kiválasztásakor érdemes bevonni, nem a szerződés aláírása előtti napon. A GDPR és generatív AI kapcsolatáról szóló útmutatónk részletesen bemutatja, mi kell az adatfeldolgozói szerződésbe.
Tesztelés bevezetés előtt és működés közben
Az LLM-rendszer biztonsága nem egyszeri vizsgálat. A modell frissül, a tudásbázis bővül, a felhasználók új módon kezdik használni. Az IVSZ vállalati AI-modellek teszteléséről szóló anyaga szerint a minőség, a költség, az üzemeltetés és az üzleti eredmények mellett rögzített regressziós tesztkészletet kell futtatni, különösen modellváltáskor vagy a környezet változásakor.
Egy magyar középvállalatnál ez a gyakorlatban így néz ki:
- Kockázati térkép a pilot előtt. Milyen adat kerül a rendszerbe, milyen műveletet hajthat végre, mi a legrosszabb reális kimenet?
- Támadó tesztek (red teaming). Szándékosan megpróbáljuk kijátszani a rendszert: utasításfelülírással, rejtett utasítást tartalmazó dokumentummal, jogosultságon túli kérdésekkel.
- Rögzített tesztkészlet. Néhány száz valós kérdés elvárt válasszal, amelyet minden változtatás után újra lefuttatunk.
- Élő monitorozás. A kimenetek mintavételes ellenőrzése, a szűrők riasztásainak figyelése, a felhasználói visszajelzések gyűjtése. Hogy mit érdemes mérni, arról az LLM-megfigyelhetőségről szóló cikkünk ad kiindulópontot.
- Időszakos felülvizsgálat. Negyedévente vagy minden nagyobb változás után új kockázatértékelés.
Uniós és magyar szabályok, amelyekre építeni kell
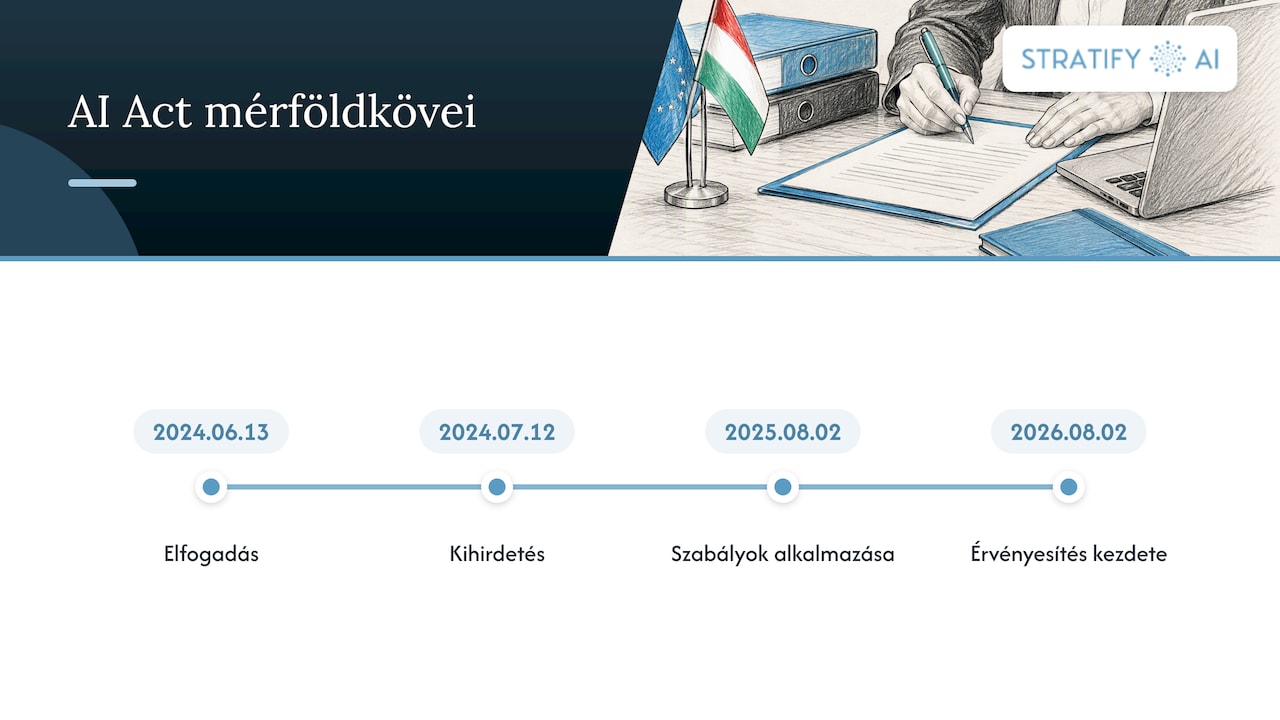
Az (EU) 2024/1689 rendelet, az AI Act a mesterséges intelligenciára vonatkozó harmonizált uniós szabályokat állapítja meg; 2024. június 13-án fogadták el és július 12-én hirdették ki. Az ENISA 2026. júliusi elemzése szerint a rendszerszintű kockázatot jelentő általános célú modellek szolgáltatóira vonatkozó kötelezettségek 2025. augusztus 2. óta alkalmazandók, és 2026. augusztus 2-tól érvényesítik őket. Ezek elsősorban a nagy modellfejlesztőket kötik, de egy felhasználó cégnek is számít, hogy a választott szolgáltató milyen dokumentációt és biztonsági garanciát tud adni. A magyar cégekre gyakorolt hatást az AI Act hatásáról szóló cikkünk foglalja össze.
Ha az LLM személyes adatot kezel, a GDPR is irányadó. Az EDPB útmutatója a kockázatkezelést a GDPR 25. (beépített és alapértelmezett adatvédelem) és 32. cikkére (az adatkezelés biztonsága) építi, kiegészítve az adatvédelmi hatásvizsgálattal (DPIA). Konkrét jogi helyzetben, például egészségügyi vagy pénzügyi adatok feldolgozásánál, a DPIA-t az adatvédelmi tisztviselővel vagy adatvédelmi jogásszal készítse el, mert a kötelezettség az adatkezelés jellegétől függ.
Hogyan látjuk mi
Gyakran látjuk, hogy a cégek az LLM-biztonságot eszközkérdésnek tekintik: melyik szűrőt vegyék meg, melyik modell a biztonságosabb. Mi máshol kezdjük. Az első kérdés az, milyen üzleti problémát old meg a rendszer, milyen adatra van ehhez valóban szüksége, és milyen döntést hozhat önállóan. Ha ez tiszta, a kontrollok nagy része magától kirajzolódik.
Ezért nálunk a governance, az adatbiztonság, az emberi felügyelet, az auditálhatóság és a megfelelés nem utólag hozzáadott réteg, hanem a tervezés része az első workshoptól. Fokozatosan vezetünk be: előbb egy szűk, jól mérhető pilot korlátozott jogosultságokkal, aztán bővítés, ha a számok és a tesztek alátámasztják. Vendorfüggetlenül dolgozunk, így a modellt és az üzemeltetési formát a cég kockázati profiljához választjuk, nem fordítva. A biztonságos LLM nem az, amelyik soha nem hibázik, hanem az, amelynek a hibái kicsik, láthatók és kijavíthatók.
— Zsolt
Biztonságos LLM-bevezetés lépésről lépésre
Ha a cég most dönt arról, hol és hogyan használjon nyelvi modellt, az AI Discovery Workshop jó kiindulópont: egyszeri, 390 000 Ft-os alkalom, amelyen az üzleti célokból kiindulva azonosítjuk és rangsoroljuk a lehetőségeket, az adatkockázatokkal együtt.

Ha már fut egy LLM-alapú megoldás, és szeretné tudni, mennyire kontrollált, az AI-átvilágítás és AI compliance szolgáltatásunk ebben segít. Új rendszernél a kontrollált AI-bevezetés a lehetőségfelméréstől a pilotig kíséri végig a projektet.
Gyakori kérdések
Biztonságos-e a ChatGPT-hez hasonló eszközöket céges adatokkal használni?
Attól függ, melyik konstrukcióban. Egy nyilvános, ingyenes felületbe bemásolt szerződés más kockázat, mint egy üzleti szerződés alapján, kikapcsolt modelltanítással és EU-s adattárolással használt szolgáltatás. A döntés előtt nézze meg az adatfelhasználási feltételeket, és rögzítse belső szabályzatban, milyen adat kerülhet bele.
Mi a különbség a prompt injection és a jailbreak között?
A jailbreak célja a modell saját tartalmi korlátainak megkerülése, például tiltott tartalom kicsikarása. A prompt injection egy alkalmazás utasításait írja felül, vagyis a cég saját rendszerét fordítja a cég ellen. Vállalati szempontból az utóbbi a súlyosabb, mert adatszivárgáshoz vagy jogosulatlan művelethez vezethet.
Kell-e adatvédelmi hatásvizsgálat egy belső AI-asszisztenshez?
Ha az asszisztens személyes adatot dolgoz fel, és az adatkezelés valószínűleg magas kockázattal jár, a GDPR szerint igen. Belső tudásbázisnál ez azon múlik, milyen dokumentumok kerülnek bele. A minősítést az adatvédelmi tisztviselővel együtt végezze el, még a fejlesztés elején.
Mennyi idő alatt lehet biztonságosan bevezetni egy LLM-megoldást?
Egy jól körülhatárolt pilot jellemzően néhány hónap alatt eljut a mérhető eredményig, ha az adatok elérhetők és a felelősök kijelöltek. A bevezetés hosszát leginkább az integrációk száma és a kezelt adatok érzékenysége határozza meg. A lépésekről az AI pilot indításáról szóló útmutatónk ad részletes képet.
Források
- EDPB: AI Privacy Risks & Mitigations – Large Language Models (LLMs)
- Óbudai Egyetem: LLM sebezhetőségek, prompt injektálás, adatszivárgás
- Nemzeti Kiberbiztonsági Intézet: Hogyan tegyük biztonságossá az AI-ügynököket?
- IVSZ: Hogyan teszteljünk vállalati AI-modellt?
- Az Európai Parlament és a Tanács (EU) 2024/1689 rendelete
- ENISA: Cybersecurity in the frontier AI era